Mời bạn thưởng thức Newsletter #103.
Drunk Post: Things I’ve Learned as a Senior Engineer
Bài viết lưu giữ lại một bài đăng nổi tiếng trên r/ExperiencedDevs, nơi một kỹ sư dữ liệu với 10 năm kinh nghiệm “ngà ngà say” và viết ra mọi bài học nghề nghiệp của mình. Tài khoản gốc đã bị xóa, nhưng sự thẳng thắn hiếm có khiến bài viết vẫn được chia sẻ rộng rãi. Về sự nghiệp, tác giả cho rằng chuyển công ty là cách thăng tiến hiệu quả nhất, chức danh ít quan trọng hơn những gì bạn thực sự làm được, và càng gần sản phẩm, gần doanh thu thì bạn càng được coi trọng, bất kể công việc kỹ thuật đến đâu.
Về kỹ thuật, mỗi lĩnh vực chỉ có khoảng 10–20 nguyên tắc cốt lõi, và nền tảng thay đổi rất chậm dù công nghệ thay đổi liên tục. Mã nguồn tốt là mã nguồn kỹ sư junior đọc hiểu được, còn mã nguồn tốt nhất là không cần viết dòng nào. Viết tài liệu là kỹ năng bị đánh giá thấp nhất, đi cùng khả năng viết đề xuất thay đổi. Với người mới, SQL là ngôn ngữ “đáng tiền” nhất; kiểm thử rất quan trọng nhưng TDD thì bị thần thánh hóa. Kỹ sư giỏi biết các thực hành tốt nhất, còn kỹ sư senior biết khi nào nên phá vỡ chúng. Điều khiến tác giả tự hào nhất không phải hệ thống lớn nào, mà là giúp người khác làm việc tốt hơn. Người lưu giữ bài viết đồng ý với gần hết, chỉ trừ quan điểm ưa chuộng ngôn ngữ động.
How I Use AI to Code
Chris Parsons cho rằng nếu vẫn gắn chặt với IDE như Cursor hay Copilot, bạn đang đi sau một năm: công cụ tốt nhất đã rời trình soạn thảo để chuyển sang dòng lệnh, và ông khuyên dùng Claude Code hoặc Codex CLI. Lập trình là “sân nhà” của AI vì mã nguồn có thể chạy để kiểm chứng ngay. Ông phân biệt “vibe coding” (không kiểm tra kết quả) với “agentic engineering” (chủ động quyết định thay đổi nào cần tự xem, thay đổi nào giao cho kiểm thử và công cụ tự động). Thông điệp chính: kỹ sư cấp cao nên huấn luyện AI viết mã tốt hơn thay vì tự review từng thay đổi, bởi cái khung (harness) bao quanh mô hình quan trọng hơn câu lệnh.
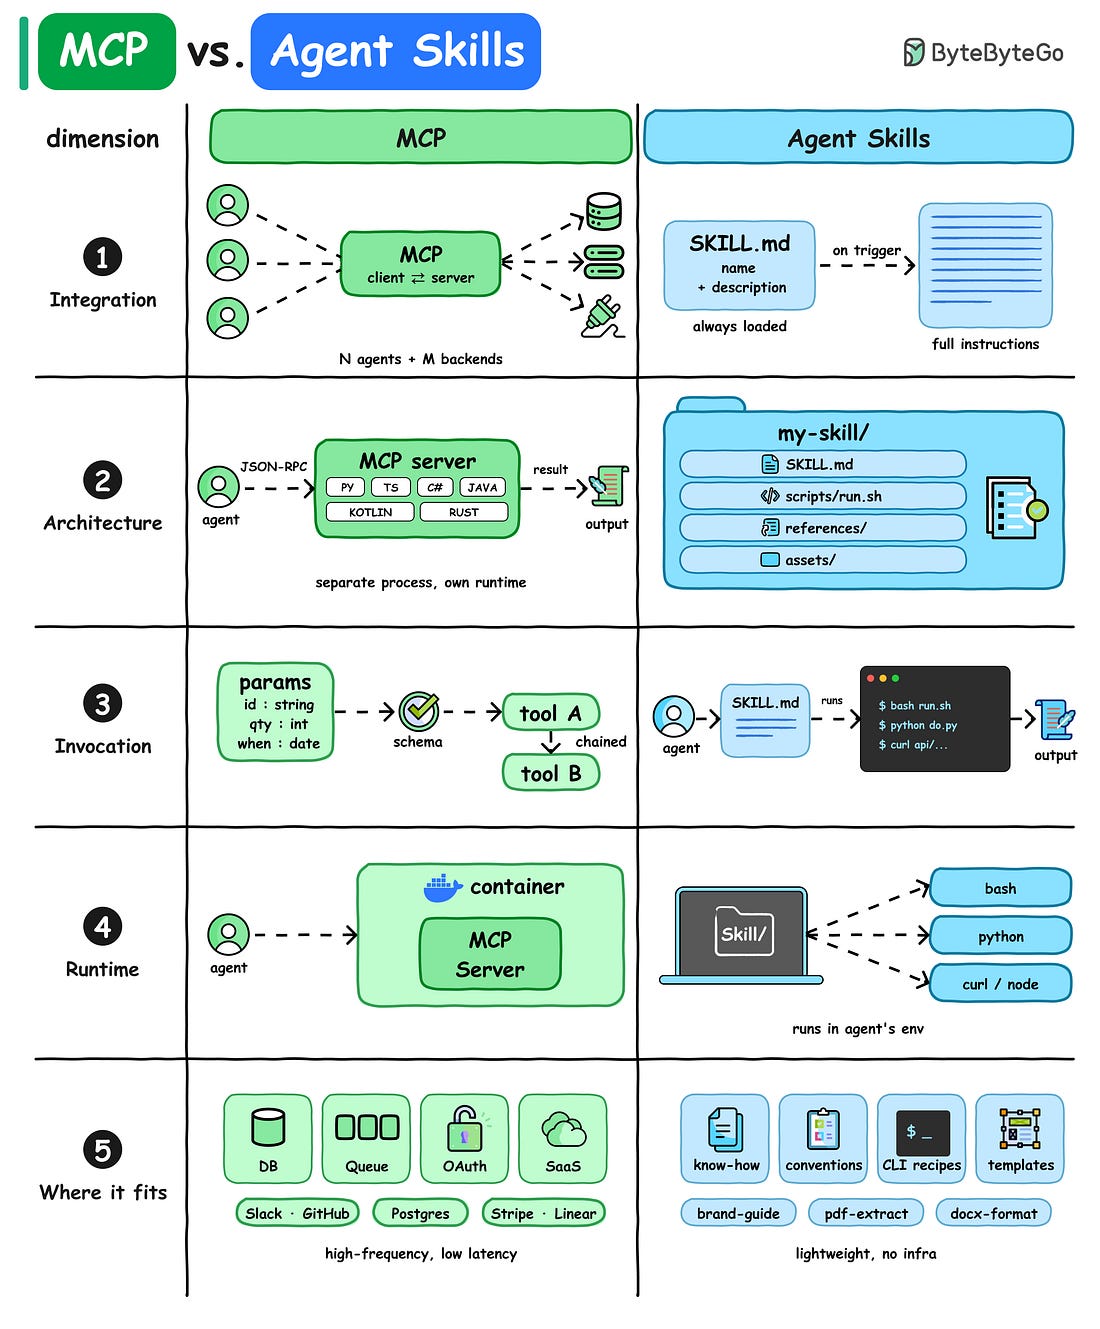
Một harness tốt gồm hướng dẫn cố định trong CLAUDE.md hoặc AGENTS.md, các tệp skill vừa áp đặt quy tắc vừa nạp thêm ngữ cảnh khi cần, một vòng lặp kiểm chứng để agent tự kiểm tra, và vòng phản hồi đưa bài học ngược vào ba thành phần trên; toàn bộ tri thức được lưu trong một kho markdown riêng. Tác giả cũng rút lại lời khuyên đặc tả toàn bộ giải pháp từ đầu, vì đó là mô hình thác nước trá hình: hãy đặc tả vấn đề, đừng đặc tả giải pháp. Chất lượng đầu ra phụ thuộc vào lượng ngữ cảnh — quá ít thì kết quả chung chung, quá nhiều thì mô hình “chìm trong nhiễu”. Khi việc sinh mã không còn là nút thắt, khâu kiểm chứng trở thành nút thắt mới, nên những nhóm đã có nền tảng kiểm thử tự động và CI/CD vững chắc sẽ có lợi thế lớn.
Email is crazy
Email là một trong những công nghệ truyền thông thành công nhất lịch sử, nhưng bên dưới là một hệ thống chắp vá với hơn 100 RFC. Sam Khawase lần theo hành trình một bức thư từ Alice đến Bob: ứng dụng thư chỉ “nộp” thư cho máy chủ, máy chủ chuyển thư tra bản ghi MX trong DNS để tìm nơi nhận, và email thực chất là hệ thống hàng đợi có cơ chế thử lại trong nhiều ngày chứ không phải thời gian thực. SMTP được thiết kế cuối thập niên 70 cho mạng học thuật dựa trên sự tin tưởng, nên địa chỉ phong bì (MAIL FROM) và tiêu đề From mà người dùng nhìn thấy được phép khác nhau — lỗ hổng gốc rễ khiến phishing và thư rác hoạt động được.
Thay vì sửa SMTP, ngành công nghiệp vá thêm ba lớp: SPF (danh sách IP được phép gửi, nhưng hỏng khi thư bị chuyển tiếp), DKIM (chữ ký mật mã với khóa công khai đặt trên DNS) và DMARC (buộc tiêu đề From khớp với tên miền đã xác thực, kèm chính sách none, quarantine hoặc reject). Thư còn phải qua lớp lọc riêng của từng nhà cung cấp: uy tín IP, uy tín tên miền, phân tích nội dung, quét virus và kiểm tra liên kết. Mã hóa cũng chỉ là “Opportunistic TLS”: nếu máy chủ nhận không hỗ trợ STARTTLS, kết nối rơi về văn bản thuần, và TLS chỉ mã hóa đường truyền chứ không mã hóa đầu cuối. Tệ nhất, thư có thể bị âm thầm chuyển vào mục thư rác mà không ai được báo — hoàn toàn hợp lệ theo RFC 5321. Dù vậy, email vẫn chuyển tin cậy hàng tỷ tin nhắn mỗi ngày.
High Performance Git
“High Performance Git” là cuốn sách của Ted Nyman về kiến trúc bên trong Git và cách vận hành các kho mã nguồn lớn. Thay vì dạy vài lệnh quen thuộc, sách nhìn Git như nhiều lớp chồng lên nhau — một cơ sở dữ liệu định địa chỉ theo nội dung, một bộ nhớ đệm hệ thống tệp, một bộ duyệt đồ thị và một giao thức truyền dữ liệu — rồi phân tích chi phí hiệu năng của từng lớp.
Nội dung đi từ đối tượng, refs, index và duyệt lịch sử đến packfile, bảo trì kho, sparse checkout, partial clone, giao thức truyền tải, vận hành ở quy mô lớn, chẩn đoán sự cố, cấu hình và khôi phục dữ liệu. Sách dành cho những ai cần Git luôn nhanh khi kho mã, lịch sử và đội ngũ ngày càng lớn: kỹ sư build và CI, người phụ trách monorepo, nhóm năng suất phát triển. Toàn bộ nội dung được phát hành miễn phí dưới dạng PDF với giấy phép Creative Commons Attribution-ShareAlike 4.0.
You can beat the binary search
Daniel Lemire tìm cách tăng tốc việc kiểm tra một giá trị trong mảng số nguyên 16-bit đã sắp xếp — thao tác thường gặp trong định dạng Roaring Bitmap, vốn đang dùng tìm kiếm nhị phân. Ông dựa trên hai nhận xét: CPU hiện đại (cả ARM 64-bit lẫn x64) đều có lệnh SIMD so sánh tám số 16-bit cùng lúc, và có khả năng song song ở mức bộ nhớ rất tốt, nên chia mảng làm bốn thay vì làm đôi có thể hiệu quả hơn. Từ đó ra đời thuật toán SIMD Quad: chia mảng thành các khối 16 phần tử, dùng tìm kiếm nội suy bậc bốn trên phần tử cuối của mỗi khối để khoanh vùng, rồi dùng SIMD kiểm tra cả 16 phần tử trong khối đó cùng lúc.
Kết quả đo trên Apple M4 và Intel Emerald Rapids cho thấy SIMD Quad nhanh hơn tìm kiếm nhị phân trong mọi trường hợp: trên Intel nhanh hơn hơn 2 lần khi bộ nhớ đệm “nóng”, còn trên Apple thì hơn 2 lần khi bộ nhớ đệm “lạnh”. Phần “bậc bốn” gần như không tạo khác biệt trên Apple, nhưng giúp đáng kể trên Intel với mảng lớn và bộ nhớ đệm lạnh. Bài học rút ra: các thuật toán kinh điển không được thiết kế cho những máy tính có nhiều khả năng song song như hiện nay, nên vẫn còn nhiều dư địa để cải thiện hiệu năng.
How might a browser be developed?
Paul Kinlan đặt câu hỏi: trình duyệt sẽ được phát triển thế nào trong thời đại AI? Xuất phát từ các thử nghiệm xây dựng trình duyệt bằng AI và những con chip chạy mô hình cực nhanh, ông nhận thấy một bộ đặc tả đầy đủ cùng thật nhiều kiểm thử đơn vị là “rào chắn” tốt để giữ mô hình đi đúng hướng. Trong ngắn hạn, các tổ chức tiêu chuẩn có thể xây một “trình duyệt tham chiếu” để tìm lỗ hổng trong đặc tả và bộ kiểm thử, còn các nhà cung cấp trình duyệt dùng AI để triển khai tính năng từ những đặc tả được kiểm thử kỹ. Khi đó, trọng tâm chuyển sang viết đặc tả tốt, và các trình duyệt khác nhau ở tầm nhìn về web hơn là năng lực kỹ thuật hay ngân sách.
Tầm nhìn xa hơn mang màu sắc khoa học viễn tưởng: trình duyệt tự sinh phần triển khai ngay lúc chạy từ mã đánh dấu, thậm chí chỉ từ mô tả ý định. Chẳng hạn, thay vì phụ thuộc vào WebBluetooth, trình duyệt có thể tự tạo kết nối với thiết bị đo nhịp tim dựa trên tài liệu phần cứng sẵn có. Điều này có thể xóa bỏ polyfill, giúp khả năng tiếp cận và đa ngôn ngữ trở thành mặc định, nhưng cũng đe dọa lời hứa cốt lõi của web: cùng một URL mang lại trải nghiệm gần như nhau cho mọi người, vì trải nghiệm giờ phụ thuộc vào thiết bị và mô hình của từng người. Kinlan kêu gọi ngành công nghiệp sớm suy nghĩ nghiêm túc về hướng đi này.
Agentic Coding is a Trap
Lars Faye cảnh báo về xu hướng “agentic coding”, nơi AI viết toàn bộ mã nguồn còn con người chỉ lập kế hoạch và điều phối. Vấn đề cốt lõi là “nghịch lý giám sát” mà chính Anthropic đã thừa nhận: muốn dùng AI hiệu quả thì phải giám sát nó, nhưng giám sát lại đòi hỏi đúng những kỹ năng lập trình đang mai một khi lạm dụng AI. Một nghiên cứu khác của Anthropic ghi nhận kỹ năng gỡ lỗi giảm tới 47%. Khác với các lần chuyển đổi trước như từ assembly sang FORTRAN, lần này tác động đã hiện rõ ở cả kỹ sư lâu năm, còn kỹ sư junior mất đi quá trình vật lộn với mã nguồn vốn là cách học quan trọng nhất.
Tác giả cho rằng AI đang tăng tốc sai chỗ: chúng ta không thực sự cần viết mã nhanh hơn, nhất là mã mình không hiểu, và với nhiều người, viết mã chính là cách tư duy và lập kế hoạch. Ngoài ra còn có rủi ro phụ thuộc nhà cung cấp — khi Claude gặp sự cố, nhiều nhóm phải ngừng làm việc — và chi phí token khó dự đoán, trong khi chi phí nhân sự thì cố định. Giải pháp của ông là hạ AI xuống vai trò phụ trợ: dùng AI để lập đặc tả và kế hoạch nhưng tự viết từ 20% đến 100% mã nguồn tùy nhiệm vụ, không bao giờ sinh nhiều mã hơn mức có thể review trong một lần ngồi, và không nhờ AI làm việc mà bản thân chưa từng hoặc không thể tự làm.
Be the Idiot
luminousmen lập luận rằng phần lớn thất bại trong kỹ thuật xảy ra vì ai đó sợ trông ngốc nghếch, nên đặt câu hỏi làm rõ không phải điểm yếu mà là một kỹ năng chuyên nghiệp. Tác giả lấy cảm hứng từ giao thức liên lạc quân sự: người nhận luôn đọc lại mệnh lệnh để xác nhận, không phải vì kém cỏi mà vì hiểu đúng quan trọng hơn trông thông minh. Hai nguyên tắc được áp dụng vào kỹ thuật: lặp lại thông tin quan trọng qua nhiều kênh như kiểu dữ liệu, docstring và tên tham số tường minh; và chọn từ ngữ không thể hiểu sai, chẳng hạn timeout_seconds: 30 thay vì timeout: short.
Tác giả chia sẻ bốn câu hỏi “ngốc” đã cứu mình nhiều lần: điều gì xảy ra khi nó thất bại, làm sao biết nó đang chạy đúng, “xong” trông như thế nào, và bạn có thể cho xem ví dụ không. Cách hỏi cũng quan trọng: thay vì “Sao chúng ta lại làm điều ngớ ngẩn này?”, hãy hỏi “Có lý do cụ thể nào khiến chúng ta dùng X ở đây không?” — tức là giả định mình đang thiếu ngữ cảnh chứ không phải người khác sai. Khoảng 80% trường hợp tác giả đúng là thiếu thông tin, 20% còn lại câu hỏi mở ra một cuộc thảo luận hữu ích. Bởi thứ duy nhất đắt hơn việc trông ngốc trong cuộc họp là xây sai sản phẩm vì không ai dám hỏi.
3 constraints before I build anything
Jordan Lord chia sẻ ba ràng buộc anh áp dụng trước khi xây dựng bất kỳ sản phẩm nào, đúc kết sau 10 năm làm sản phẩm và nhiều lần thất bại vì sản phẩm quá phức tạp hoặc thiếu bản sắc. Với anh, ràng buộc là chất xúc tác cho sáng tạo vì nó thu hẹp không gian lựa chọn. Ràng buộc đầu tiên là “một trang hoặc không làm”: mọi ý tưởng phải gói gọn trong một bản mô tả một trang, dùng làm kim chỉ nam khi trao đổi với nhà đầu tư, đồng đội hay gia đình. Không viết đủ một trang nghĩa là chưa sẵn sàng; cần nhiều hơn một trang nghĩa là quá phức tạp.
Ràng buộc thứ hai: công nghệ lõi phải tách rời được khỏi sản phẩm. Đó có thể là phương pháp, công cụ hay thư viện hỗ trợ sản phẩm hiện tại nhưng vẫn tồn tại khi sản phẩm đổi hướng, giống như Git ra đời để phục vụ việc phát triển nhân Linux, hay Kubernetes của Google. Sản phẩm có thể xoay trục, còn công nghệ lõi thì tích lũy giá trị theo thời gian. Ràng buộc thứ ba: một ràng buộc định nghĩa phải định hình sản phẩm và luôn hiện diện trước mắt người dùng, như Minecraft xây hoàn toàn từ khối vuông hay IKEA với đồ nội thất đóng gói phẳng tự lắp ráp. Nó chống lại việc nhồi nhét tính năng và tạo nên bản sắc. Ý tưởng nào không vượt qua cả ba ràng buộc thì không được xây dựng.
Swissing a Table
Phil Pearl tìm hiểu Swiss table — thiết kế bảng băm đứng sau cách triển khai map mới của Go — bằng cách đi từng bước từ một bảng băm địa chỉ mở đơn giản. Đầu tiên, anh thay dò tuyến tính bằng chuỗi dò có bước tăng dần như Go; sau đó gom 8 cặp khóa–giá trị thành một nhóm; tiếp theo thêm 8 byte điều khiển cho mỗi nhóm (bit cao nhất đánh dấu ô trống, 7 bit thấp lưu một phần giá trị băm); và cuối cùng dùng thủ thuật thao tác bit trên số 64-bit để so khớp cả 8 byte điều khiển cùng lúc thay vì kiểm tra từng ô.
Kết quả đo thời gian chèn cho thấy Swiss table không phải lúc nào cũng thắng: khi bảng còn vơi (khoảng 10–4000 phần tử), nó chậm hơn bảng đơn giản khoảng 19–36%, chỉ vượt lên khi bảng đầy dần và nhanh hơn tới 71,65% khi bảng đầy hoàn toàn (32.768 phần tử). Theo tác giả, lợi ích lớn nhất là bảng có thể chạy ở mức lấp đầy cao mà hiệu năng giảm rất ít — tức là cơ hội tiết kiệm bộ nhớ hơn là tăng tốc vượt bậc. Hiện map của Go chỉ dùng SIMD trên chip Intel, chưa dùng trên ARM, nên tác giả để dành hướng SIMD cho bài viết sau.
The AI engineering stack we built internally — on the platform we ship
Cloudflare chia sẻ hạ tầng AI nội bộ họ xây dựng trong 11 tháng, chạy hoàn toàn trên chính các sản phẩm bán cho khách hàng. Trong 30 ngày, 3.683 người dùng nội bộ (93% bộ phận R&D) dùng công cụ lập trình AI, với hơn 20 triệu yêu cầu qua AI Gateway và 241 tỷ token; có tuần số merge request gần gấp đôi mức nền của quý trước. Kiến trúc gồm ba tầng. Tầng nền tảng dùng Cloudflare Access để xác thực theo mô hình zero-trust, AI Gateway để định tuyến, theo dõi chi phí và kiểm soát việc lưu trữ dữ liệu, còn Workers AI chạy các mô hình mã nguồn mở với chi phí thấp hơn nhiều so với mô hình độc quyền. Chỉ một lệnh đăng nhập là mọi cấu hình được thiết lập, và quyết định định tuyến qua một Worker trung gian ngay từ đầu giúp họ bổ sung tính năng về sau mà không phải sửa cấu hình phía người dùng.
Tầng tri thức dùng Backstage làm danh mục dịch vụ và tự động sinh tệp AGENTS.md cho khoảng 3.900 kho mã nguồn, mô tả cấu trúc, quy ước và ranh giới để agent không phải tự đoán. Tầng thực thi có AI Code Reviewer đánh giá mọi merge request: phân loại mức rủi ro, giao việc cho các agent chuyên biệt, trình bày phát hiện theo danh mục và mức độ nghiêm trọng, đồng thời trích dẫn quy tắc cụ thể từ Engineering Codex — bộ tiêu chuẩn kỹ thuật nội bộ được đóng gói thành agent skill. Theo Cloudflare, từng thành phần không có gì mới; điểm khác biệt nằm ở cách kết nối chúng với nhau.
Bonus
Images:
Bài viết đã được viết lại bởi Claude Code với Opus 5.5 vào ngày 27/09/2026.