Mời bạn thưởng thức Newsletter #85.
How I Use Claude Code
Boris Tane chia sẻ quy trình anh đã dùng với Claude Code suốt khoảng 9 tháng, xoay quanh một nguyên tắc: không bao giờ để Claude viết mã khi chưa có bản kế hoạch bằng văn bản được đọc kỹ và phê duyệt. Cách này giữ quyền quyết định kiến trúc trong tay lập trình viên và cho kết quả tốt hơn hẳn. Ở bước nghiên cứu, tác giả yêu cầu Claude đọc “thật sâu” phần mã nguồn liên quan rồi ghi lại hiểu biết vào tệp research.md; thiếu những từ nhấn mạnh như vậy, Claude sẽ chỉ đọc lướt. Tệp này giúp kiểm tra Claude có hiểu đúng hệ thống không, vì lỗi đắt nhất khi lập trình cùng AI là những thay đổi chạy được riêng lẻ nhưng phá vỡ phần còn lại.
Tiếp theo, Claude viết plan.md gồm hướng tiếp cận, đoạn mã minh họa, các tệp cần sửa và các đánh đổi. Phần giá trị nhất là vòng chú thích: tác giả ghi chú trực tiếp vào kế hoạch để sửa giả định sai, loại bỏ phương án thừa hoặc bổ sung kiến thức nghiệp vụ, rồi yêu cầu Claude cập nhật kèm câu chặn “chưa triển khai vội”. Vòng này lặp lại 1 đến 6 lần, sau đó kế hoạch được bổ sung danh sách việc cần làm chi tiết. Khi mọi quyết định đã rõ, một câu lệnh chuẩn yêu cầu Claude làm hết mọi việc, đánh dấu tiến độ ngay trong kế hoạch và liên tục kiểm tra kiểu dữ liệu. Việc triển khai khi đó trở nên “nhàm chán”: chỉ cần phản hồi ngắn, hoàn tác khi đi sai hướng, và chạy toàn bộ quy trình trong một phiên dài để Claude tích lũy ngữ cảnh.
Next-Generation DB Ingestion at Pinterest
Pinterest giới thiệu phần đầu loạt bài về khung nhập liệu cơ sở dữ liệu thế hệ mới, thay cho các quy trình chạy theo lô cũ. Hệ thống cũ có độ trễ thường vượt quá 24 giờ, xử lý lại toàn bộ bảng mỗi ngày dù phần thay đổi dưới 5%, và không hỗ trợ xóa theo từng hàng. Khung mới dựa trên cơ chế bắt thay đổi dữ liệu (CDC) với Debezium/TiCDC, Kafka, Flink, Spark và Iceberg, hỗ trợ MySQL, TiDB và KVStore. Dịch vụ CDC ghi sự kiện vào Kafka với độ trễ dưới một giây, Flink ghi chúng vào bảng CDC Iceberg chỉ nối thêm trên S3 (trễ dưới 5 phút), còn Spark định kỳ lấy bản thay đổi mới nhất của từng khóa chính và dùng Merge Into để cập nhật bảng cơ sở, bản sao của bảng trực tuyến với độ trễ 15 phút đến một giờ.
Nhóm chọn Merge-on-Read thay vì Copy-on-Write vì cách sau tốn chi phí lưu trữ cao hơn nhiều. Bài viết chia sẻ ba tối ưu. Thứ nhất, phân vùng bảng cơ sở theo giá trị băm của khóa chính bằng hàm bucket() để dữ liệu phân bố đều và Spark xử lý song song. Thứ hai, đặt WRITE DISTRIBUTED BY PARTITION để gom dữ liệu cùng phân vùng vào một lần ghi, khắc phục tình trạng sinh quá nhiều tệp nhỏ. Thứ ba, với bảng cực lớn, nhóm đổ dữ liệu CDC vào một bảng tạm có cùng cách phân vùng để dùng bucket join, tránh xáo trộn toàn bộ bảng cơ sở trước mỗi lần gộp, nhờ đó giảm hơn 40% chi phí tính toán và giảm đáng kể độ trễ. Phần tiếp theo sẽ bàn về tự động tiến hóa lược đồ dữ liệu.
Thank you, AI
Gerd Hoffmann kể lại việc phải khép lại máy chủ git tự vận hành mà ông duy trì công khai từ năm 2011, trước đó là máy chủ CVS. Các bot thu thập dữ liệu cho AI đã dội hàng loạt yêu cầu vô nghĩa vào giao diện web cgit cho đến khi máy chủ nhỏ bé này sập hẳn, trong khi cách hiệu quả nhất để lấy toàn bộ kho chỉ đơn giản là clone nó về. Không muốn dành thời gian rảnh để chiến đấu với các bot, tác giả quyết định không dựng lại máy chủ nữa mà chuyển hẳn sang GitLab và GitHub, nơi phần lớn kho đã có bản sao sẵn, đồng thời sửa lại các liên kết cũ để trỏ về đó.
Dịch vụ tự vận hành duy nhất còn lại là máy chủ web chứa blog, vốn đã chuyển từ WordPress sang Jekyll từ năm 2018 nên chỉ gồm các trang tĩnh và gần như không thể bị quá tải. Dù vậy, các bot vẫn gây ra một sự cố khác: hàng triệu phản hồi 404 không đủ để chúng hiểu rằng cgit đã biến mất, và tệp nhật ký phình to nhanh đến mức logrotate với cấu hình mặc định không kịp xoay vòng, làm đầy ổ đĩa. Tác giả đã chỉnh lại cấu hình. Câu chuyện ngắn này cho thấy gánh nặng thực tế mà làn sóng thu thập dữ liệu cho AI đang đặt lên những người tự vận hành dịch vụ nhỏ.
Java UI in 2026: The Complete Guide
Robin Tegg tổng hợp hơn 25 framework và thư viện giao diện người dùng viết bằng Java tính đến năm 2026, chia theo bốn nền tảng: web, máy tính để bàn, di động và terminal. Thông điệp chính là đây không phải những dự án cũ kỹ còn cầm cự mà là công nghệ sẵn sàng cho môi trường thực tế, được bảo trì tích cực và đang chạy ở doanh nghiệp lớn, ngân hàng, cơ quan chính phủ với hàng trăm triệu người dùng. Với web, Vaadin và Apache Wicket cho phép viết toàn bộ giao diện bằng Java mà không cần JavaScript, PrimeFaces và Jakarta Faces phục vụ hệ sinh thái Jakarta EE, HTMX kết hợp Spring Boot đi theo hướng hypermedia, j2html sinh HTML an toàn kiểu, Thymeleaf là lựa chọn mẫu giao diện truyền thống, còn TeaVM biên dịch bytecode Java sang JavaScript hoặc WebAssembly.
Trên máy tính để bàn, JavaFX là tiêu chuẩn hiện đại, JCEF nhúng Chromium để dùng giao diện HTML/CSS, Swing được làm mới nhờ FlatLaf, còn NetBeans Platform và Eclipse RCP phù hợp ứng dụng mô-đun lớn có hệ thống plugin. Với di động, Codename One cho phép viết một lần chạy mọi nơi và biên dịch iOS trên đám mây mà không cần máy Mac, còn Gluon Mobile mở rộng JavaFX bằng biên dịch native qua GraalVM. Ở mảng terminal, JLine xử lý nhập liệu dòng lệnh và được Maven, Gradle sử dụng, còn Lanterna cung cấp bộ công cụ dựng giao diện dạng văn bản. Mỗi framework đều kèm mô tả, ví dụ mã và liên kết để bắt đầu, cùng bảng gợi ý chọn công cụ theo từng tình huống.
Java Full Stack Development in 2026
Tác giả kể lại việc chuyển trang www.scanii.com từ ứng dụng Spring Boot dùng webpack và TypeScript sang kiến trúc gọn hơn, nơi toàn bộ việc hiển thị diễn ra phía máy chủ. Theo ông, xu hướng React, TypeScript và mã nguồn tách đôi chỉ hợp lý khi có các nhóm chuyên biệt; với một nhóm nhỏ gồm những người làm được nhiều việc, cách đơn giản mang lại năng suất lớn hơn. Kết quả là mã nguồn hợp nhất chỉ cần một nút “Run” trong IntelliJ, thời gian đóng gói giao diện về 0 kèm tự động tải lại, trang vẫn cập nhật từng phần như ứng dụng một trang, đạt 100 điểm hiệu năng Lighthouse và dễ gỡ lỗi hơn vì không còn bước chuyển mã.
Quá trình gồm ba bước. Đầu tiên là chọn bộ mẫu giao diện được Spring Boot hỗ trợ; nhóm chọn JTE vì dùng được toàn bộ JDK ngay trong mẫu. Tiếp theo là bỏ công cụ đóng gói, thay bằng importmaps thuộc chuẩn HTML, kết hợp webjars để phục vụ thư viện trực tiếp từ ứng dụng mà không cần CDN bên thứ ba. Cuối cùng là thêm tính tương tác bằng Turbo và Stimulus của Hotwire, theo hướng của Rails, để có cập nhật trang từng phần và một khung MVC quen thuộc cho phần JavaScript còn cần. Hai điểm vướng lớn là thiếu tải lại nóng, được giải quyết bằng việc trình duyệt thăm dò thay đổi còn máy chủ theo dõi hệ thống tệp, và cơ chế chống CSRF của Spring Security dựa trên mã ngẫu nhiên trong mỗi biểu mẫu, vốn xung đột với bộ nhớ đệm trang của Turbo. Nhóm tự viết bộ lọc CSRF dựa trên header Sec-Fetch-Site của trình duyệt.
Sharding Databases with Spring Boot: Patterns, Pitfalls, and Failure Modes
Bài hướng dẫn giải thích sharding, tức chia dữ liệu theo chiều ngang ra nhiều cơ sở dữ liệu nhỏ, và cách hiện thực nó với Spring Boot. Sharding cần thiết khi việc nâng cấp một máy chủ chạm giới hạn, truy vấn chậm dần theo kích thước dữ liệu, thông lượng ghi thành nút thắt hoặc cần tăng tính sẵn sàng. Quyết định quan trọng nhất là chọn khóa phân mảnh như mã người dùng hay mã khách thuê: khóa cần có nhiều giá trị khác nhau, phục vụ phần lớn truy vấn trên một shard và gần như không đổi. Bài so sánh bốn chiến lược chia theo khoảng, theo hàm băm, theo bảng tra cứu và theo địa lý, rồi chỉ ra rằng phép chia lấy dư đơn giản khiến gần như mọi khóa phải di chuyển khi thêm bớt shard, còn consistent hashing chỉ ảnh hưởng khoảng 1/N số khóa.
Phần hiện thực trình bày cách cấu hình nhiều nguồn dữ liệu, dịch vụ xác định shard và một JdbcTemplate có định tuyến. Truy vấn chứa khóa phân mảnh đi thẳng tới một shard, truy vấn không chứa khóa phải gửi tới mọi shard rồi gộp kết quả. Join giữa các shard khó nhất, có thể xử lý bằng phi chuẩn hóa, join trong ứng dụng hoặc đặt dữ liệu liên quan cùng shard. Commit hai pha chậm và dễ treo khi bộ điều phối gặp sự cố, nên tác giả khuyên dùng mẫu Saga và chấp nhận nhất quán sau cùng. Bài còn đề cập giám sát bằng Actuator, di chuyển dữ liệu bằng ghi kép và các lỗi thường gặp như chọn sai khóa, cố định số shard hay thiếu sao lưu riêng cho từng shard. Lời khuyên: chỉ sharding khi thật cần.
Go Made Me Fast, Rust Made Me Care, AWS Made Me Pay
Tác giả kể lại rằng nhiều năm dùng Go trên AWS mọi thứ đều có vẻ ổn, triển khai nhanh, đội ngũ năng suất, nhưng trên đám mây hệ thống hiếm khi hỏng ồn ào mà “hỏng về mặt tài chính”. Go xứng đáng là lựa chọn mặc định cho backend nhờ mô hình đồng thời đơn giản, thư viện chuẩn mạnh, tệp thực thi nhỏ, khởi động nhanh và thường hỏng theo cách dễ đoán. Vấn đề là sự kém hiệu quả tích tụ âm thầm: thêm 10% CPU chỗ này, 200MB bộ nhớ chỗ kia, thêm một máy “cho chắc”. Bộ thu gom rác của Go dù tốt vẫn có giá: bộ nhớ dự phòng, chu kỳ CPU, độ trễ khó đoán khi tải cao và mật độ container thấp hơn, còn AWS chỉ việc gửi hóa đơn.
Rust xuất hiện khi các dịch vụ thông lượng cao và đường ống dữ liệu luồng bắt đầu gây khó cho Go. Tác giả nhấn mạnh Rust không nhanh hơn một cách thần kỳ; nó buộc lập trình viên đối mặt với cấp phát bộ nhớ, quyền sở hữu dữ liệu, bố cục bộ nhớ và hành vi bộ nhớ đệm. Dịch vụ Rust đầu tiên mất gấp ba thời gian để viết, nhưng khi chạy thì bộ nhớ phẳng, độ trễ ổn định, CPU đúng dự kiến. Nhờ đó dùng được máy EC2 nhỏ hơn, mật độ container cao hơn và ít lỗi hết bộ nhớ trên ECS/EKS, chi phí Lambda thấp hơn với tác vụ nặng CPU. Bài học là đặt ngôn ngữ đúng chỗ: Go cho API, logic nghiệp vụ và mã kết nối; Rust cho đường ống dữ liệu, thành phần nhạy cảm độ trễ và tác vụ nặng CPU.
The Cloud Is Not Your Computer: Why Go and Rust Developers Secretly Miss the Monolith
Bài viết của cùng tác giả với giọng văn châm biếm, cho rằng đám mây không phải máy tính của bạn mà là một cuộc thương lượng. Viết Go hay Rust cho cảm giác mọi thứ xác định và trong tầm kiểm soát, nhưng trên đám mây “máy chủ” là ảo, “ổ đĩa” nằm qua mạng, “mạng” do phần mềm định nghĩa và ranh giới bảo mật chỉ là một chính sách IAM chép từ đâu đó, nên bạn không thực sự chạy phần mềm mà đang “thuê xác suất”. Go giả định mọi thứ đều có thể hỏng và lặng lẽ trả về error, còn Rust buộc bạn chứng minh quyền sở hữu bộ nhớ, nhưng chương trình an toàn đó vẫn phải chạy sau hàng lớp container, cụm, VPC, bộ cân bằng tải và CDN. Bạn sửa lỗi trong mã, trong khi thủ phạm là security group hay một chỉ mục bị thiếu.
Tác giả hoài niệm kiến trúc nguyên khối vì nó dễ đoán, dễ triển khai và dễ gỡ lỗi: chỉ cần SSH vào một máy, đọc nhật ký và sửa, thay vì mở CloudWatch, Prometheus, Grafana, Datadog mà vẫn không hiểu vì sao lỗi 503 xảy ra. Dù vậy, Go và Rust vẫn phát triển mạnh trên đám mây vì chúng là những ngôn ngữ trung thực trong một môi trường thiếu trung thực: Go coi lỗi là giá trị hạng nhất, Rust bảo đảm tính đúng đắn lúc biên dịch, cả hai đều giảm bớt sự bất định. Vì thế, kỹ sư đám mây giỏi ngày nay không chỉ viết mã tốt mà còn hiểu cấu trúc mạng, phạm vi ảnh hưởng của IAM, chiến lược giám sát, ngân sách độ trễ, vùng lỗi và mô hình chi phí.
Bonus
Hình ảnh:
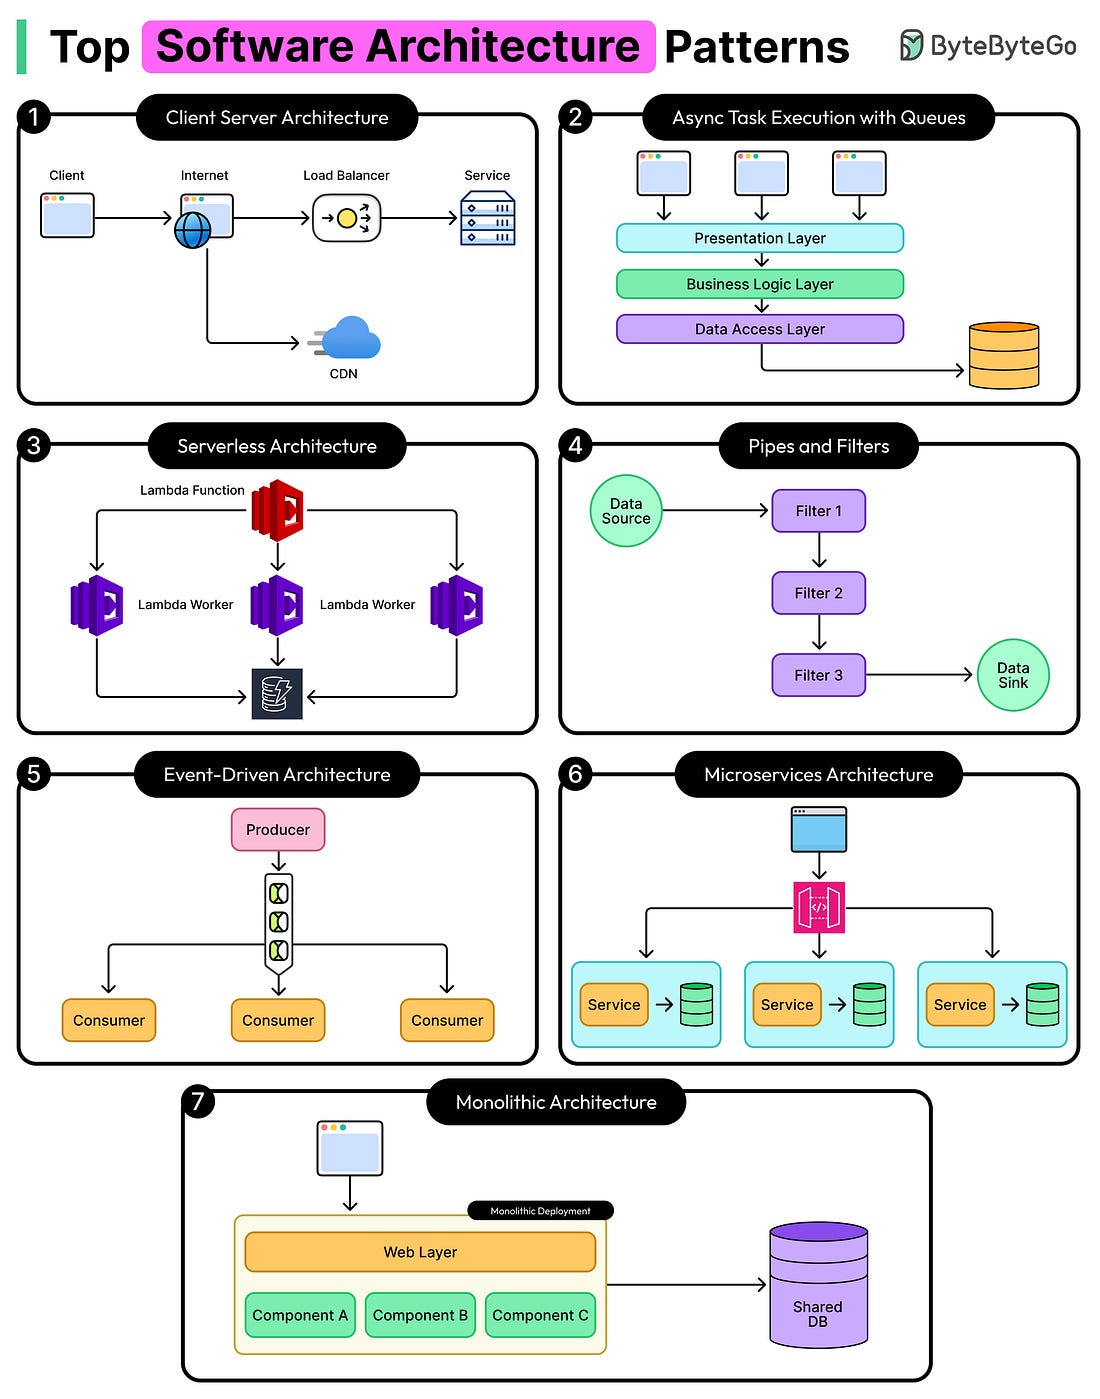
Bài viết đã được viết lại bởi Claude Code với Opus 5.5 vào ngày 27/09/2026.