Mời bạn thưởng thức Newsletter #75.
Front-End vs. Back-End vs. System Design – What’s the Difference in Interviews?
Ba vòng phỏng vấn front-end, back-end và system design đánh giá những bộ kỹ năng rất khác nhau, vì vậy mỗi vòng cần một chiến lược chuẩn bị riêng. Phỏng vấn front-end xoay quanh phía client: HTML, CSS, JavaScript và thường là một framework như React. Vòng này ít đặt nặng thuật toán phức tạp mà nghiêng về kiến thức chuyên môn như thiết kế responsive, độ ưu tiên của CSS, cách trình duyệt hiển thị trang, JavaScript bất đồng bộ hay tối ưu thời gian tải. Phỏng vấn back-end mang tính truyền thống hơn: cấu trúc dữ liệu, thuật toán kiểu LeetCode kèm phân tích độ phức tạp, cộng thêm kiến thức về API, cơ sở dữ liệu (SQL và NoSQL, chỉ mục, thiết kế schema), bộ nhớ đệm và hàng đợi thông điệp. Phỏng vấn system design thì nhìn toàn cảnh, kiểm tra khả năng thiết kế một hệ thống thực tế từ đầu sao cho mở rộng được, tin cậy và dễ bảo trì.
Tác giả dùng phép so sánh với việc xây nhà: front-end giống thiết kế nội thất (các phòng trông và tạo cảm giác ra sao), back-end giống kết cấu và móng (ngôi nhà có đứng vững và vận hành tốt không), còn system design giống vai trò kiến trúc sư của cả khu dân cư, quyết định vị trí nhà cửa, đường sá và tiện ích. Để chuẩn bị cho front-end, nên tự làm vài dự án nhỏ, ôn lại kiến thức nền về trình duyệt và HTTP. Với back-end, việc luyện thuật toán và nắm vững cơ sở dữ liệu vẫn là trọng tâm.
Why Starting with Microservices Can Be Your Biggest Architectural Mistake
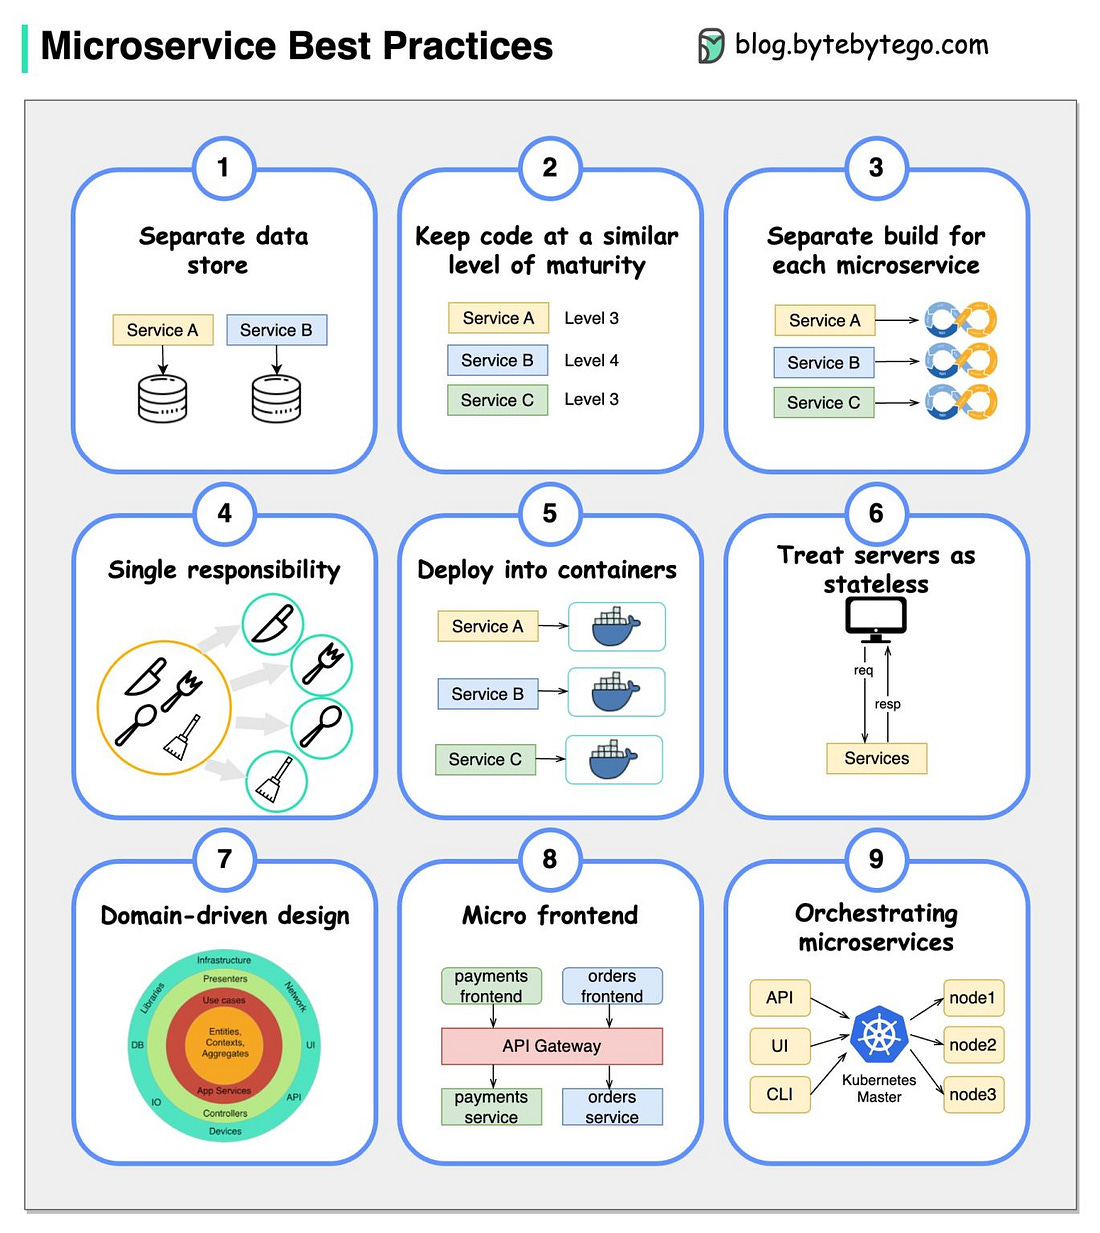
Microservices thường được xem là “cách làm chuẩn”, nhưng bắt đầu một dự án mới bằng microservices lại là một sai lầm phổ biến và đắt giá: thứ phù hợp với đội 5.000 kỹ sư thường là thuốc độc cho đội năm người. Lời khuyên cốt lõi là “Monolith First”. Monolith có một siêu năng lực là sự đơn giản: toàn bộ mã nguồn ở một chỗ, triển khai một lần và lời gọi hàm diễn ra tức thì vì cùng vùng nhớ. Microservices kéo theo ba cơn ác mộng. Thứ nhất, mạng không đáng tin cậy nên lời gọi hàm biến thành bài toán hệ phân tán với retry và timeout. Thứ hai, mỗi dịch vụ có cơ sở dữ liệu riêng nên không thể JOIN giữa các bảng, phải tự ghép dữ liệu trong mã nguồn. Thứ ba, 10 dịch vụ nghĩa là 10 pipeline build, 10 máy chủ cần giám sát và 10 nơi phải lục log.
Lúc mới bắt đầu, ta cũng chưa biết hệ thống nên được chia thế nào. Tái cấu trúc monolith chỉ là chuyển file giữa các thư mục, còn tái cấu trúc microservices đòi hỏi thay đổi hợp đồng API, di chuyển cơ sở dữ liệu và phối hợp nhiều lần triển khai. Giải pháp trung gian là Modular Monolith: một codebase duy nhất nhưng tổ chức gọn gàng thành các module như /src/users, /src/orders nhưng vẫn chạy chung một runtime. Cách này mang lại sự rõ ràng của microservices mà không có gánh nặng vận hành. Chỉ nên chuyển sang microservices khi đội quá lớn (khoảng 100 người), khi các tính năng cần mở rộng khác nhau, hoặc khi cần đa dạng công nghệ. Đừng tối ưu sớm; hãy đợi đến khi nỗi đau thật sự xuất hiện.
The Linux kernel is just a program
Bài viết giải mã Linux kernel, thứ vốn bị xem như một “hộp đen” bí ẩn, thông qua các thí nghiệm thực tế. Kernel về bản chất cung cấp một lớp trừu tượng để dùng phần cứng một cách thuận tiện và an toàn: API thống nhất để tương tác với phần cứng, quản lý cách chương trình dùng CPU, bộ nhớ và tài nguyên, kiểm soát quyền truy cập. Phép so sánh gần nhất là kernel chính là một “runtime” cho máy tính. Trên hầu hết bản phân phối, kernel chỉ là một tệp nén vài MB như vmlinuz-… nằm trong thư mục /boot.
Tác giả sao chép tệp đó ra và chạy bằng QEMU; kernel khởi động trong khoảng 2 giây rồi panic vì không tìm thấy root filesystem để giao quyền cho chương trình init, và đây là hành vi đúng. Tiếp theo, tác giả viết một chương trình init đơn giản bằng Go, đóng gói nó vào một initramfs tối giản rồi khởi động lại. Lần này kernel chạy chương trình Go với PID 1. Từ thí nghiệm, người đọc rút ra nhiều khái niệm quan trọng: bản phân phối Linux chỉ là kernel cộng các chương trình và tệp cấu hình; process là chương trình đang thực thi; PID là mã định danh của process; init là process đầu tiên, có nhiệm vụ khởi động các chương trình khác; và ranh giới giữa kernel space với user space nằm ở thời điểm init bắt đầu chạy. Cách tiếp cận thực hành này giúp xây dựng mô hình tư duy về cách Linux vận hành.
Why Your Load Balancer is the Bottleneck (and How to Fix It)
Hệ thống phân tán có một nghịch lý: bạn thêm load balancer để phân phối lưu lượng đều cho các máy chủ ứng dụng, nhưng khi sản phẩm tăng trưởng mạnh, chính nó lại trở thành nút thắt. Máy chủ ứng dụng vẫn chạy ổn, cơ sở dữ liệu còn nhàn rỗi, vậy mà người dùng vẫn than trang chậm hoặc không truy cập được. Theo tác giả, đây là điểm phân biệt lập trình viên junior với kiến trúc sư senior: nhiều người biết cách thêm load balancer, nhưng rất ít người biết phải làm gì khi chính nó là vấn đề. Bài viết giải thích vì sao điều này xảy ra và giới thiệu năm chiến lược mở rộng mà các công ty công nghệ lớn áp dụng.
Một số chiến lược được nêu gồm: DNS Round Robin để chia lưu lượng ngay từ tầng DNS, lựa chọn giữa định tuyến Layer 4 và Layer 7 để giảm khối lượng xử lý, và Direct Server Return (DSR) cho phép phản hồi từ máy chủ đi thẳng tới client mà không quay lại load balancer. Mỗi cách đều có đánh đổi: DNS Round Robin đơn giản nhưng thay đổi lan truyền chậm, Layer 4 nhanh hơn Layer 7 nhưng ít tính năng hơn, còn DSR tiết kiệm băng thông nhưng đòi hỏi cấu hình mạng phức tạp. Nắm vững các chiến lược này giúp tầng load balancer mở rộng theo chiều ngang cùng các máy chủ ứng dụng thay vì trở thành điểm nghẽn duy nhất.
The High Availability Blueprint: Designing Systems That Never Sleep
High Availability (HA) là cách xây dựng hệ thống “không bao giờ ngủ” trên nền phần cứng chắc chắn sẽ hỏng. HA không chỉ là ngăn sự cố mà còn là che giấu nó để người dùng không hề hay biết. Độ sẵn sàng được đo bằng “số số 9”: 99% tương đương khoảng 3,65 ngày ngừng hoạt động mỗi năm, 99,9% khoảng 8,76 giờ, còn 99,999% chỉ khoảng 5 phút; mỗi số 9 thêm vào lại khó và đắt hơn theo cấp số nhân. Triết lý cốt lõi là “giả định mọi thứ sẽ hỏng và lên kế hoạch cho điều đó”. Kẻ thù lớn nhất là Single Point of Failure (SPOF), tức bất kỳ thành phần nào mà khi hỏng sẽ kéo cả hệ thống ngừng theo, và lời giải là dự phòng (redundancy): nhân đôi các thành phần quan trọng.
Các kỹ thuật chính gồm: load balancer kèm health check để tự động loại máy chủ hỏng khỏi vòng phân phối; sao chép cơ sở dữ liệu theo mô hình Leader-Follower, Follower được nâng lên làm Leader khi có sự cố; và chiến lược failover với hai dạng. Active-Passive đơn giản nhưng lãng phí vì máy dự phòng gần như luôn nhàn rỗi. Active-Active tận dụng hết phần cứng nhưng phức tạp hơn, và mỗi máy phải đủ sức gánh toàn bộ tải khi máy kia hỏng. Bên cạnh đó, rate limiting (trả về HTTP 429 khi vượt ngưỡng) giúp ngăn lỗi dây chuyền khi lưu lượng tăng đột biến. Để đạt năm số 9 cần phân tán địa lý, đặt máy chủ ở nhiều vùng khác nhau để vượt qua thảm họa cục bộ. Thông điệp xuyên suốt: “Two is one, and one is none”, luôn phải có phương án dự phòng.
Bonus
Images
Bài viết đã được viết lại bởi Claude Code với Opus 5.5 vào ngày 27/09/2026.