Lâu rồi chưa pay 1 cái gì liên quan đến AI (từ thời Claude subscription để thử nghiệm Claude Code). Nay mới mua thử gói GLM Coding Plan của Z.ai để trải nghiệm. Gói này hiện cho phép dùng model mới nhất của Z.ai là GLM-4.7. Từ nay mình sẽ tranh thủ dùng Claude Code với Z.ai API để ‘bào’ cho xứng đáng số tiền bỏ ra^^. Mời bạn thưởng thức Newsletter #74.
Goodbye Microservices: From 100s of problem children to 1 superstar
Twilio Segment kể lại vì sao họ từ bỏ kiến trúc microservices cho phần chuyển tiếp sự kiện tới các đích (destination) phía máy chủ. Ban đầu mọi sự kiện đi chung một hàng đợi, nên khi một đích bị chậm hoặc lỗi, các lượt thử lại làm nghẽn toàn bộ hệ thống (head-of-line blocking). Để cô lập sự cố, nhóm tạo riêng một service và một hàng đợi cho từng đích, rồi tách mã nguồn mỗi đích ra một kho riêng. Cách làm này hiệu quả lúc đầu, nhưng khi số đích tăng lên hơn 140, các thư viện dùng chung bị lệch phiên bản giữa các kho, mỗi service có kiểu tải riêng khiến việc tự động co giãn rất khó cấu hình, và ba kỹ sư phải dành phần lớn thời gian chỉ để giữ hệ thống chạy.
Giải pháp là gộp tất cả thành một service duy nhất trong một monorepo, thống nhất một phiên bản cho 120 thư viện phụ thuộc, và xây dựng Traffic Recorder để ghi lại rồi phát lại lưu lượng HTTP trong kiểm thử, giúp bộ kiểm thử của hơn 140 đích chạy xong trong vài mili giây thay vì cả giờ. Kết quả: tốc độ phát triển tăng rõ (46 cải tiến thư viện chung trong một năm so với 32 trước đó), việc co giãn dễ hơn và không còn bị gọi dậy lúc nửa đêm vì tải đột biến. Đổi lại, việc cô lập lỗi khó hơn, bộ nhớ đệm trong tiến trình kém hiệu quả hơn, và nâng cấp một thư viện có thể làm hỏng nhiều đích cùng lúc. Bài học: muốn quay về monolith thì cần một bộ kiểm thử thật vững và chấp nhận rõ ràng các đánh đổi.
5 engineering dogmas it’s time to retire
Anton Zaides đề xuất xem xét lại năm “chân lý” quen thuộc trong ngành phần mềm. Thứ nhất, “đừng phát minh lại bánh xe, hãy tìm thư viện”: lạm dụng thư viện phụ thuộc khiến dự án dễ tổn thương về bảo mật và phải chạy theo cập nhật, như vụ left-pad (chỉ khoảng 11 dòng mã) bị gỡ khỏi npm làm hỏng quá trình build của Facebook, Spotify, Netflix. Thứ hai, “mọi PR đều phải được review”: review có giá trị lớn, nhưng quy trình bắt buộc cứng nhắc làm chậm đội ngũ; ở Pylon, kỹ sư tự merge và chỉ nhờ review khi cần góp ý, khi thay đổi rủi ro hoặc khi mới vào nhóm, còn lập trình cặp cũng là một lựa chọn thay thế tốt. Thứ ba, “sprint 2–4 tuần là cách làm hiện đại”: Shape Up với chu kỳ 6 tuần kèm một đến hai tuần nghỉ khỏi dự án theo lịch cho thấy vẫn có những cách tổ chức công việc khác ngoài Scrum/Kanban.
Thứ tư, “mọi thay đổi đều nên nằm sau feature flag”: khi bị lạm dụng, hàng trăm cờ đang bật khiến mã nguồn phức tạp, khó kiểm thử và còn tạo cảm giác an toàn giả; đôi khi chỉ cần kiểm thử kỹ trên môi trường staging rồi phát hành. Thứ năm, “cần chú thích nghĩa là mã quá phức tạp”: cực đoan kiểu nào cũng không hợp lý, vì một hai dòng chú thích có thể tiết kiệm hàng giờ cho người đến sau. Tác giả kết luận rằng không quan điểm nào hoàn toàn vô lý, nhưng người quản lý kỹ thuật giỏi cần biết cân bằng chúng với thực tế của đội mình.
What Does a Database for SSDs Look Like?
Marc Brooker trả lời câu hỏi: nếu thiết kế lại từ đầu một cơ sở dữ liệu quan hệ cho SSD vào năm 2025 thì sẽ ra sao, khi Postgres hay MySQL ra đời trong thời ổ đĩa quay, còn SSD NVMe hiện nhanh hơn khoảng 1000 lần cả về thông lượng lẫn độ trễ. Áp dụng lại “quy tắc năm phút” của Jim Gray với giá máy EC2 hiện nay, bộ nhớ đệm nên giữ các trang dự kiến được đọc lại trong khoảng 30 giây để tối ưu chi phí. SSD bị giới hạn bởi thông lượng với khối truyền lớn hơn khoảng 32kB và bởi IOPS với khối nhỏ hơn, nên kích thước truyền trung bình không nên nhỏ hơn nhiều so với 32kB. Vì ghi lên SSD cục bộ chỉ bền vững trên một máy, cơ sở dữ liệu hiện đại cần sao chép đồng bộ sang vùng sẵn sàng (AZ) khác và chỉ chịu độ trễ liên AZ tại thời điểm commit, đồng thời dùng đồng hồ phần cứng chất lượng cao để có đọc mở rộng nhất quán mạnh.
Về WAL, tác giả cho rằng việc ghi xuống đĩa trên một máy vừa không cần thiết vừa không đủ; thay vào đó, giao dịch nên được commit vào một log phân tán đảm bảo độ bền trên nhiều máy, nhiều AZ, và khôi phục bằng cách phát lại log trên bất kỳ bản sao nào. Kết luận: giữ mô hình quan hệ, SQL, tính nguyên tử, cô lập (mặc định nên là SNAPSHOT) và nhất quán mạnh, nhưng chuyển độ bền, khả năng mở rộng đọc/ghi và tính sẵn sàng cao thành bài toán phân tán, đồng thời bỏ phần lớn các tối ưu cho độ bền và khôi phục cục bộ.
The Economics of System Design: FinOps, Auto-Scaling, and Spot Instances
Bài viết nhấn mạnh rằng chi phí thường bị bỏ quên trong thiết kế hệ thống, trong khi ước tính khoảng 30% chi tiêu đám mây là lãng phí do tài nguyên không được dùng hết. Những điểm kém hiệu quả nhỏ như một truy vấn thừa hay một máy chủ bỏ không có thể chẳng đáng kể với 100 người dùng, nhưng sẽ phình thành khoản chi lớn khi lên tới hàng triệu người dùng. Vì vậy chi phí cần được coi là mối quan tâm hàng đầu ngay từ khi thiết kế, bởi thêm vào sau cho một kiến trúc vốn tốn kém khó hơn nhiều.
Tác giả đưa ra năm chiến lược: thiết kế hiệu quả từ đầu, cân nhắc đánh đổi của microservices và ưu tiên sự đơn giản; chọn đúng kích thước tài nguyên, dùng tự động co giãn và các dịch vụ serverless trả theo mức sử dụng; dùng bộ nhớ đệm như Redis và tối ưu truy vấn (chỉ lấy dữ liệu cần thiết, đánh chỉ mục phù hợp) để giảm tải cơ sở dữ liệu; thường xuyên săn tìm và tắt tài nguyên nhàn rỗi, như môi trường kiểm thử bị bỏ quên, và hẹn giờ tắt hệ thống phi sản xuất vào ban đêm; cuối cùng là giám sát, đặt cảnh báo chi phí và xây dựng văn hóa FinOps, nơi kỹ sư coi chi phí như một chỉ số hiệu năng. Một hệ thống thiết kế tốt không chỉ mở rộng được và chạy nhanh, mà còn phải tiết kiệm chi phí.
The Big-O Complexity of Vibe Coders
Hiện nay vibe coding (lập trình bằng cách trò chuyện với LLM) chủ yếu được đánh giá qua tốc độ ra kết quả, nhưng tác giả dự đoán khi mức sử dụng LLM trong doanh nghiệp tăng lên, câu hỏi sẽ chuyển sang chi phí tăng trưởng như thế nào, giống cách ta phân tích độ phức tạp Big-O của thuật toán. Đội không dùng vibe coding thì chậm, còn đội lạm dụng nó, nhất là kiểu gõ một lần rồi thử lại liên tục, sẽ nhận hóa đơn token lớn mà không rõ vì sao. Mỗi lời nhắc và mỗi lần sửa đều tiêu tốn token, nên một quy trình nhiều vòng lặp nhanh có thể có độ phức tạp gần O(n²) thay vì O(n). Lời nhắc mơ hồ mở rộng không gian lời giải và buộc phải sửa nhiều lần, còn lời nhắc chính xác, nêu rõ ràng buộc từ đầu, sẽ hội tụ nhanh hơn.
Theo tác giả, người giỏi vibe coding nhất không phải người lặp nhanh nhất mà là người có “Big-O” token thấp nhất trên mỗi kết quả được đưa vào sử dụng; vibe coding giúp cá nhân nhanh hơn, còn vibe coding tiết kiệm token giúp cả đội mở rộng. Tuy vậy, cách nhìn này không phù hợp với công việc sáng tạo hay khám phá như động não hay thử các hướng đi cụt, vốn dĩ kém hiệu quả về token nhưng vẫn có giá trị, và không nên ép mọi thứ vào mục tiêu tối ưu.
Design is more than code
Karri Saarinen, đồng sáng lập Linear, cho rằng cuộc tranh luận “nhà thiết kế có nên viết mã không” là quá hạn hẹp. Câu hỏi lớn hơn là vai trò của nhà thiết kế sẽ thay đổi thế nào khi có AI và các công cụ mới, và ta mất gì nếu dồn họ sang hướng thiết kế thẳng bằng mã nguồn. Thiết kế có nhiều dạng tùy lĩnh vực, khách hàng và con người, và ngay cả kỹ sư cũng thường rời khỏi mã để vẽ kiến trúc hay cân nhắc đánh đổi. Theo ông, bước đầu tiên là “thiết kế vấn đề”: đặt câu hỏi liệu vấn đề có thật không, ai định nghĩa nó, thay vì coi nó là giả định, vì lý do phổ biến nhất khiến dự án thiết kế kéo dài hoặc thất bại là vấn đề không rõ ràng và mỗi bên nghĩ về một vấn đề khác nhau.
Tiếp theo là “thiết kế giải pháp” gồm hai giai đoạn: giai đoạn khái niệm tìm hình dạng tổng thể (ví dụ ở Linear, dự án được xem là một thực thể riêng chứ không chỉ là một nhãn gom các issue), và giai đoạn thực thi đưa ý tưởng lên màn hình, nơi mã nguồn và vật liệu thật là thiết yếu. Ông ví phần việc trước đó như mục tiêu, ngữ cảnh và lời nhắc chuẩn bị cho một agent. Điều tác giả lo ngại không phải công cụ, mà là sự suy giảm trong việc cân nhắc kỹ lưỡng khi xây thẳng lên sản phẩm trở thành mặc định; với ông, thiết kế luôn là tìm đúng vấn đề, đúng ý định và đúng tầm nhìn.
How we saved 70% CPU and 60% memory in Refinery
Honeycomb chia sẻ cách Refinery 3.0, công cụ lấy mẫu trace (tail-based sampling) viết bằng Go, giảm 70% CPU và 60% bộ nhớ trên cụm nội bộ, đủ để thu nhỏ cụm 72 nút xuống một nửa. Khi phân tích profile, họ thấy nguyên nhân gốc là mọi span đều được giải tuần tự hóa đầy đủ vào một map[string]any với hàng trăm trường, khiến khoảng 50% thời gian CPU dành cho cấp phát bộ nhớ và gần một phần tư cho thu gom rác, trong khi phần logic lấy mẫu thực sự chỉ chiếm khoảng 12%, và phần lớn span sau đó bị bỏ đi.
Giải pháp là không giải tuần tự hóa nữa: Refinery chỉ đọc chọn lọc vài trường cần thiết từ dữ liệu MessagePack rồi giữ nguyên dạng tuần tự hóa, vốn gọn hơn nhiều so với một map đầy đủ. Trong benchmark, cách đọc chọn lọc mất khoảng 17 ns và không cấp phát lần nào, so với khoảng 296 ns và 9 lần cấp phát khi đọc vào map. Các định dạng đầu vào khác (JSON, OTLP) được chuyển mã trực tiếp sang MessagePack. Nhóm cũng tối ưu phần đo đạc chỉ số, dùng pool để tái sử dụng bộ đệm lớn và song song hóa vòng lặp quyết định. Mã nguồn dài và phức tạp hơn, nhưng không cần thuật toán cao siêu hay viết lại bằng Rust, chỉ cần xác định lại tiến trình thực sự phải làm gì và chỉ làm đúng việc đó.
From Junior to Senior: 7 API Design Patterns That Scale
Bài viết trình bày bảy quyết định kiến trúc giúp API mở rộng tốt, cũng là điểm khác biệt giữa lập trình viên junior (tập trung vào logic) và senior (tập trung vào cách các hệ thống giao tiếp với nhau). Thứ nhất, thiết kế hướng tài nguyên: thay vì các endpoint kiểu RPC như POST /updateUserEmail, hãy dùng danh từ như /users và để phương thức HTTP (GET, POST, PUT, PATCH, DELETE) thể hiện hành động, giúp API dễ đoán. Thứ hai, trả đúng mã trạng thái HTTP thay vì luôn trả 200 OK kèm lỗi trong nội dung, vì công cụ giám sát, cân bằng tải và bộ nhớ đệm dựa vào mã này; phân biệt 4xx (lỗi phía client) với 5xx (lỗi phía máy chủ) rất quan trọng khi gỡ lỗi. Thứ ba, phân trang: phân trang theo offset chậm dần khi dữ liệu lớn vì cơ sở dữ liệu phải đọc qua các dòng bị bỏ qua, còn phân trang theo cursor dựa trên chỉ mục nên luôn nhanh.
Thứ tư, idempotency key giúp tránh xử lý trùng một yêu cầu, ví dụ trừ tiền hai lần khi người dùng bấm gửi lại vì mạng mất phản hồi. Thứ năm, giới hạn tần suất (rate limiting) bảo vệ hệ thống khỏi quá tải. Thứ sáu, đánh phiên bản API để không làm hỏng các client đang dùng. Thứ bảy, tài liệu đầy đủ với OpenAPI/Swagger. Thiết kế API tốt tạo nền tảng ổn định để doanh nghiệp phát triển, còn thiết kế kém sẽ trở thành điểm nghẽn.
Bonus
Images
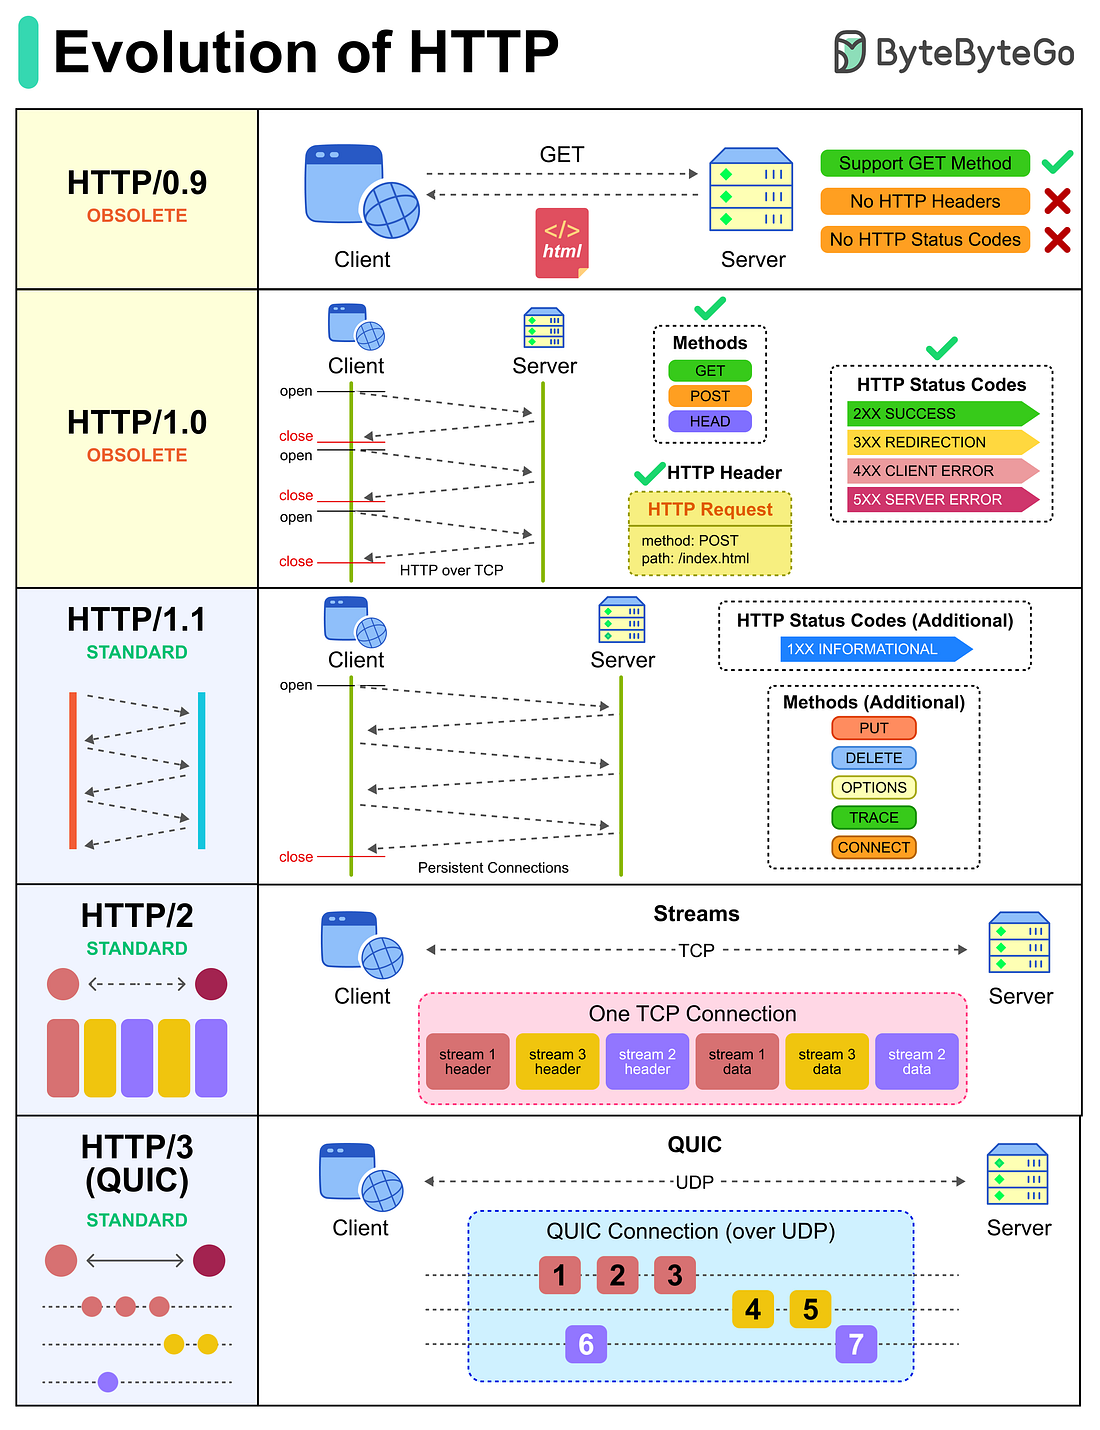
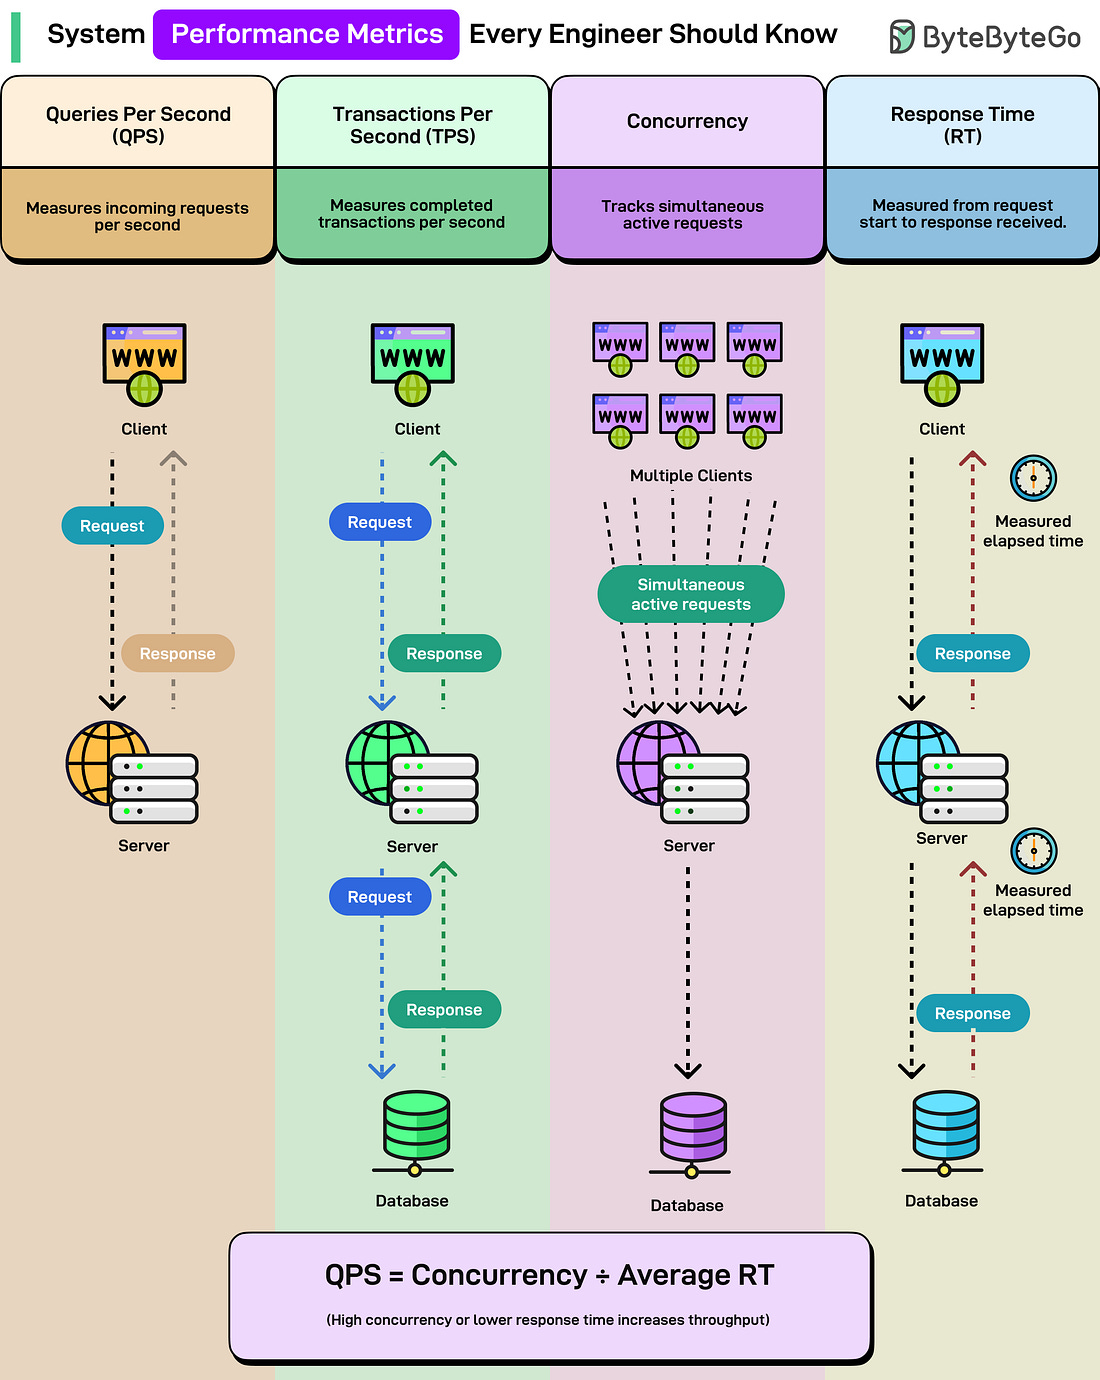
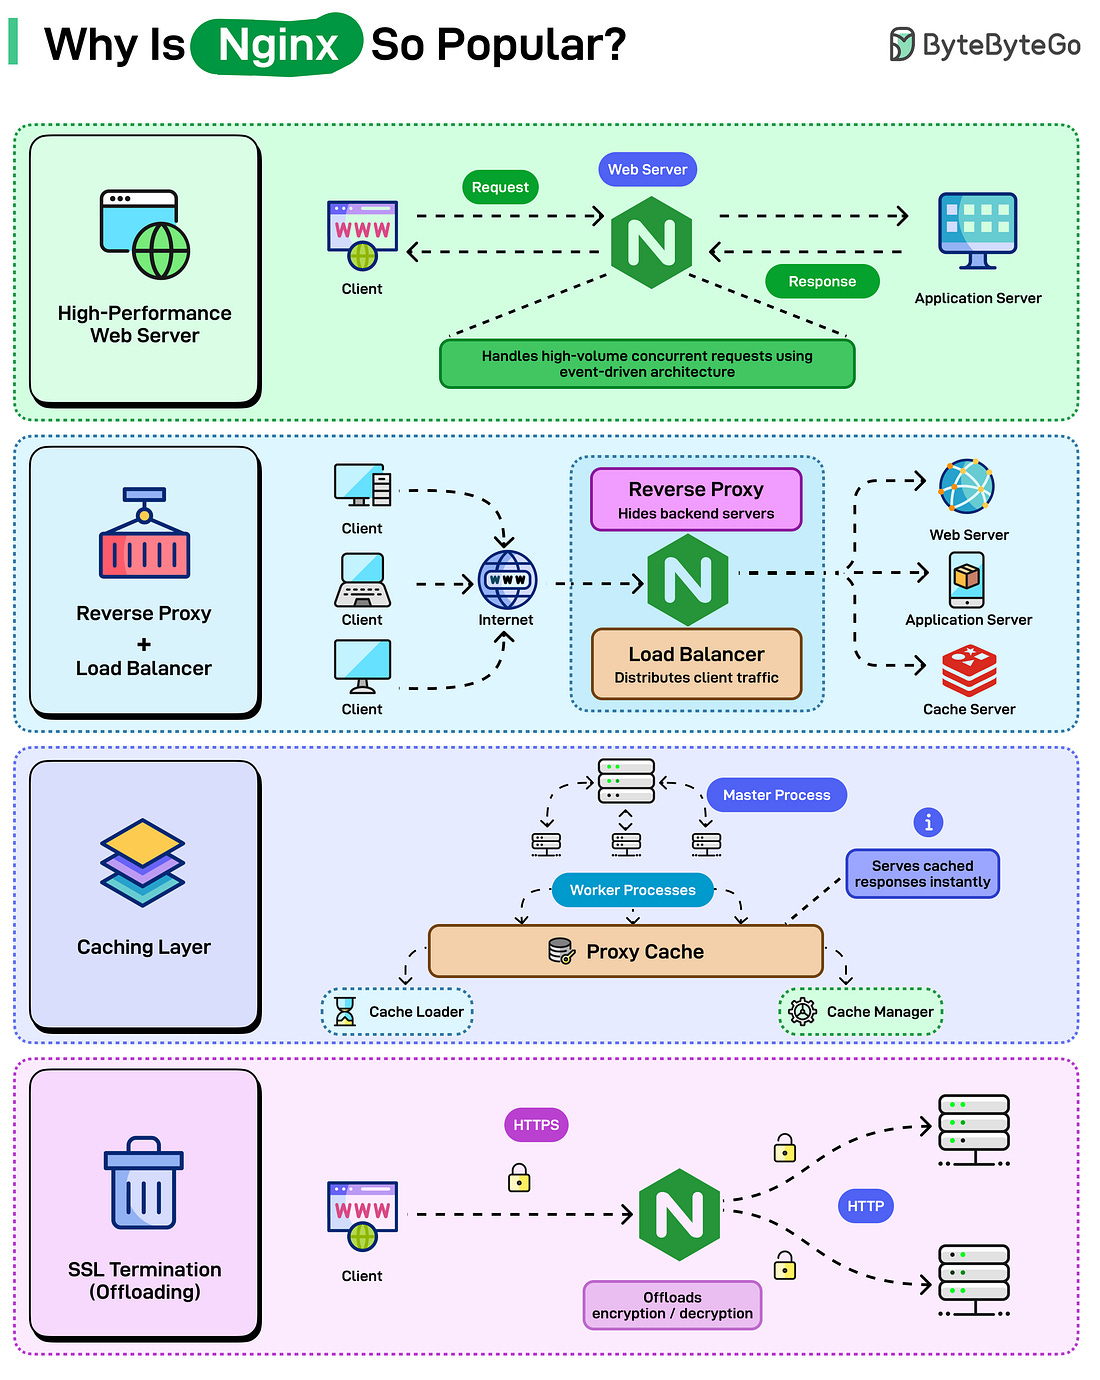

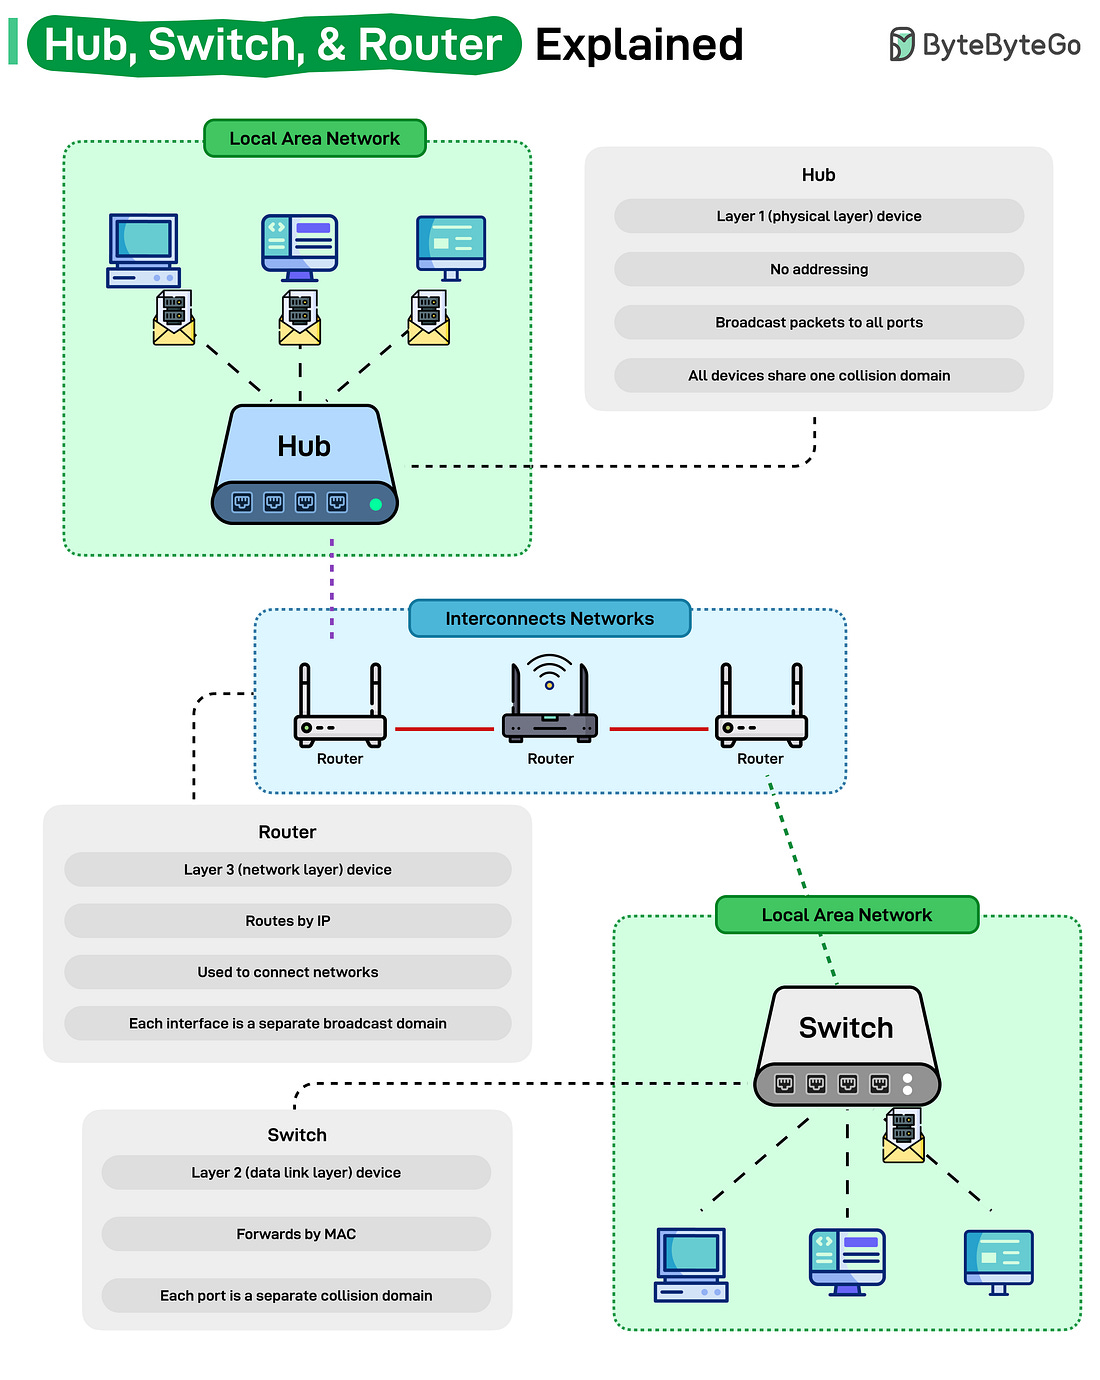
Đánh giá: Z.ai xử lý 1 url tương đối nhanh, ban đầu mình cũng thấy khá ok, tuy nhiên thêm càng nhiều thì có vẻ càng bị dài & lạm dụng tiếng Anh. Mình đã phải yêu cầu tóm gọn lại một xíu. Hi vọng sẽ cải thiện được sau (vì lỡ mua rùi và non-refundable hiuhiu)
Bài viết đã được viết lại bởi Claude Code với Opus 5.5 vào ngày 27/09/2026.