Chào các bạn, nay lại đến chu kỳ lười biếng của mình rồi (với thật ra thì dạo trước cày kha khá rồi nên nội dung còn lại cũng không nhiều), nên mình sẽ chuyển sang viết khoảng 1-2 bài/tuần tuỳ cảm hứng. Với tuần rồi mình cũng có được idol ✨🌙 của mình giới thiệu cuốn sách Tìm mình trong thế giới hậu tuổi thơ, cũng khá hay, nếu hứng thú các bạn có thể tìm đọc. Còn giờ thì mời bạn thưởng thức Newsletter #51.
p-fast trie: lexically ordered hash map
Tony Finch phác thảo một ý tưởng cấu trúc dữ liệu mà chính ông cũng chưa chắc là hay: “p-fast trie”, một dạng hash map vẫn giữ được thứ tự từ điển của khóa. Thay vì duy trì cây và các con trỏ nội bộ như qp-trie, p-fast trie lưu mọi tiền tố (ngắn hơn khóa) của mọi khóa vào một hash map chia thành nhiều tầng, mỗi tiền tố ứng với một nút trong. Khóa được xem như chuỗi bit cắt thành từng khúc 6 bit; mỗi nút trong chứa một bitmap 64 bit đánh dấu những khúc tiếp theo có tồn tại, kèm một mảng nén bằng popcount trỏ tới lá gần nhất phía trước. Các lá nối thành danh sách liên kết vòng theo thứ tự, nên tìm được lá liền trước là có ngay lá liền sau. Nhờ vậy, tìm kiếm chính xác chỉ là một lần tra hash map O(1), còn tìm phần tử liền trước/liền sau dùng tìm kiếm nhị phân trên độ dài tiền tố, đạt O(log k) thay vì O(k) như qp-trie (k là độ dài khóa).
Tác giả cũng thẳng thắn chỉ ra các điểm yếu: p-fast trie tốn bộ nhớ hơn nhiều vì cần rất nhiều nút trong, thao tác chèn và xóa phải cập nhật nhiều tiền tố cùng lúc nên khó làm an toàn khi chạy đa luồng, và việc nhảy qua lại giữa các tiền tố dài khiến bộ nhớ đệm CPU kém hiệu quả hơn qp-trie. Ưu thế còn lại là tìm phần tử liền trước/liền sau chỉ cần một lần duyệt thay vì hai. Đây là bài ngắn, hợp với những bạn muốn học cách một kỹ sư cân nhắc đánh đổi khi thiết kế cấu trúc dữ liệu.
Big O vs Hardware: Better Complexity ≠ Better Performance
Abhinav Upadhyay chỉ ra rằng độ phức tạp thuật toán tốt hơn không đảm bảo chạy nhanh hơn trên phần cứng thật. Ông dựa vào “định luật sắt” (Iron Law) về hiệu năng: thời gian chạy phụ thuộc vào số lệnh cần thực thi và số lệnh CPU hoàn thành trong mỗi chu kỳ (IPC). Bài viết so sánh ba thuật toán tìm ước chung lớn nhất (GCD): Euclid dùng phép trừ với O(max(a, b)), Euclid dùng phép chia lấy dư với O(log(max(a, b))), và thuật toán nhị phân của Stein. Với đầu vào rất lớn, bản chia lấy dư nhanh hơn bản phép trừ khoảng 10.000 lần. Nhưng với a = 130000, b = 13, bản phép trừ dù lặp gần 10.000 lần vẫn xong sớm hơn bản chia lấy dư chỉ cần một bước, vì trên Intel Skylake phép cộng/trừ có độ trễ 1 chu kỳ và chạy được 4 lệnh mỗi chu kỳ, còn phép chia số nguyên có độ trễ 42–95 chu kỳ.
Thuật toán Stein thân thiện với phần cứng hơn: thay phép chia bằng phép dịch bit và lệnh đếm số bit 0 ở cuối, nên vừa ít lệnh vừa giữ IPC cao. Khi tính GCD cho các cặp số trong khoảng [1, 100000), Stein nhanh nhất; bản chia lấy dư chạy ít lệnh nhất (13 tỷ) nhưng IPC chỉ 0,15 nên chậm nhất, còn bản phép trừ chạy tới 97 tỷ lệnh mà vẫn xong sớm hơn 1,5 giây. Bài học rút ra: Big O vẫn quan trọng khi dữ liệu lớn, nhưng muốn nhanh thật thì cần hiểu chi phí từng lệnh trên CPU, đo đạc bằng công cụ như perf, và cân nhắc kết hợp thuật toán theo kích thước đầu vào.
Claude Code Is All You Need
Gareth Dwyer, người quen làm mọi thứ bằng vim, kể lại vài tuần dùng Claude Code, công cụ lập trình bằng AI chạy trong terminal của Anthropic, cùng ba bài học chính: trao cho nó nhiều quyền tự chủ (ông chạy ở chế độ bỏ qua xác nhận quyền, kể cả trên máy chủ thật), cung cấp thật nhiều đầu vào vì chất lượng đầu ra tỉ lệ thuận với ngữ cảnh, và nó thiết kế giao diện tốt bất ngờ. Ví dụ tiêu biểu là SmartSplit, bản sao SplitWise được tạo chỉ bằng một lệnh từ tệp đặc tả khoảng 500 từ; nhưng mô hình vẫn thiếu ổn định, và một đặc tả sơ sài cho ra ứng dụng hỏng hoàn toàn. Ông thấy mô hình viết PHP rất tốt và cho rằng framework chủ yếu phục vụ con người chứ không phải AI.
Theo tác giả, sức mạnh của Claude Code nằm ở một vòng lặp đơn giản gọi mô hình liên tục. Ông thử kéo dài vòng lặp đó thành một “startup tự vận hành” trên VPS: Claude tự viết prompt, chọn ý tưởng và dựng ứng dụng web hoàn chỉnh kèm Nginx và chứng chỉ, dù ý tưởng của nó thực ra vô lý, rồi cuối cùng bị chặn vì vi phạm chính sách sử dụng. Ở việc thật, Claude Code giúp ông chuyển một ứng dụng Laravel/MySQL xa lạ sang VPS giá rẻ, ước tính tiết kiệm 16–32 giờ, dù vẫn cần ông giám sát. Ngoài ra còn có plugin chấm điểm bình luận HackerNews, công cụ làm poster và việc phân loại sao kê ngân hàng. Riêng bài viết này, ông vẫn tự viết gần như toàn bộ, vì thấy mô hình giỏi sắp xếp nội dung hơn là sáng tạo.
HTTP is not simple
Daniel Stenberg, tác giả curl với gần ba thập kỷ viết mã HTTP phía client và tham gia soạn các đặc tả HTTP tại IETF, phản bác quan niệm “HTTP là giao thức đơn giản”. HTTP/1 trông dễ vì là văn bản đọc được và ai cũng có thể telnet vào máy chủ gõ tay lệnh GET, nhưng cỗ máy bên dưới thì không hề đơn giản. Header tổ chức theo dòng, độ dài dòng không có giới hạn trong đặc tả, kết thúc bằng CRLF nhưng đôi khi chỉ LF, và là chuỗi octet chứ không phải UTF-8. Khoảng trắng lúc bắt buộc lúc tùy chọn, token có thể nằm trong ngoặc kép hoặc không. Có ít nhất ba cách xác định điểm kết thúc body (Content-Length, chunked encoding, Connection: close), nguồn gốc của vô số lỗ hổng bảo mật; phân tích số ở dạng văn bản phải lo tràn số, dấu và số 0 ở đầu; header còn có thể bị gộp hoặc “gấp” sang dòng sau.
Chưa kể những tính năng có trong đặc tả nhưng hiếm khi dùng được như pipelining hay mã phản hồi 100, việc gửi body kèm GET không tương thích rộng rãi (dẫn tới đề xuất phương thức QUERY), và các trình duyệt thường đoán ý người dùng thay vì báo lỗi, khiến phần mềm khác phải bắt chước trình duyệt hơn là bám đặc tả. “HTTP/1.1” xuất hiện trong ít nhất 40 RFC; riêng bộ RFC 9110–9112 đã dài 95.740 từ, đọc liền mạch mất hơn bảy giờ. Tác giả cho rằng độ phức tạp có lẽ là cái giá của thành công, vì DNS hay SMTP cũng khởi đầu đơn giản rồi phức tạp dần, và HTTP sẽ chỉ càng phức tạp hơn.
Building a web search engine from scratch in two months with 3 billion neural embeddings
Wilson Lin kể lại hành trình hai tháng tự xây một công cụ tìm kiếm web từ con số không, xuất phát từ hai nhận định: kết quả tìm kiếm ngày càng lẫn nhiều nội dung SEO rác, trong khi các mô hình nhúng văn bản dựa trên transformer đã hiểu ngôn ngữ tự nhiên rất tốt. Mục tiêu là hiểu ý định của cả câu truy vấn thay vì khớp từ khóa. Trang web được chuẩn hóa để loại bỏ menu, chân trang, phần bình luận và chỉ giữ văn bản mang ngữ nghĩa, sau đó tách thành từng câu bằng mô hình của spaCy; mỗi câu được gắn thêm ngữ cảnh từ tiêu đề mục hay câu dẫn trước danh sách để những câu tham chiếu gián tiếp không bị mất nghĩa.
Ở quy mô lớn, cụm 200 GPU tạo ra 3 tỷ vector nhúng SBERT, hàng trăm crawler đạt đỉnh 50.000 trang mỗi giây và tạo chỉ mục 280 triệu trang; RocksDB và HNSW được phân mảnh trên 200 lõi CPU, 4 TB RAM và 82 TB SSD, cho độ trễ truy vấn đầu cuối khoảng 500 ms. Bài viết cũng kể vì sao phải bỏ dịch vụ lưu trữ đối tượng rồi PostgreSQL để chuyển sang RocksDB, và cách chọn Hetzner, Oracle Cloud, Runpod giúp chi phí rẻ hơn AWS hàng chục lần. Hai bài học lớn nhất: số lượng chính là chất lượng, vì không tìm thấy thì vô dụng; và crawl cùng lọc nội dung mới là phần khó nhất. Hướng đi tiếp theo gồm tận dụng Common Crawl, dùng mô hình nhúng tĩnh, viết lại crawler bằng Rust và xây chỉ mục tập trung vào nội dung chất lượng cao.
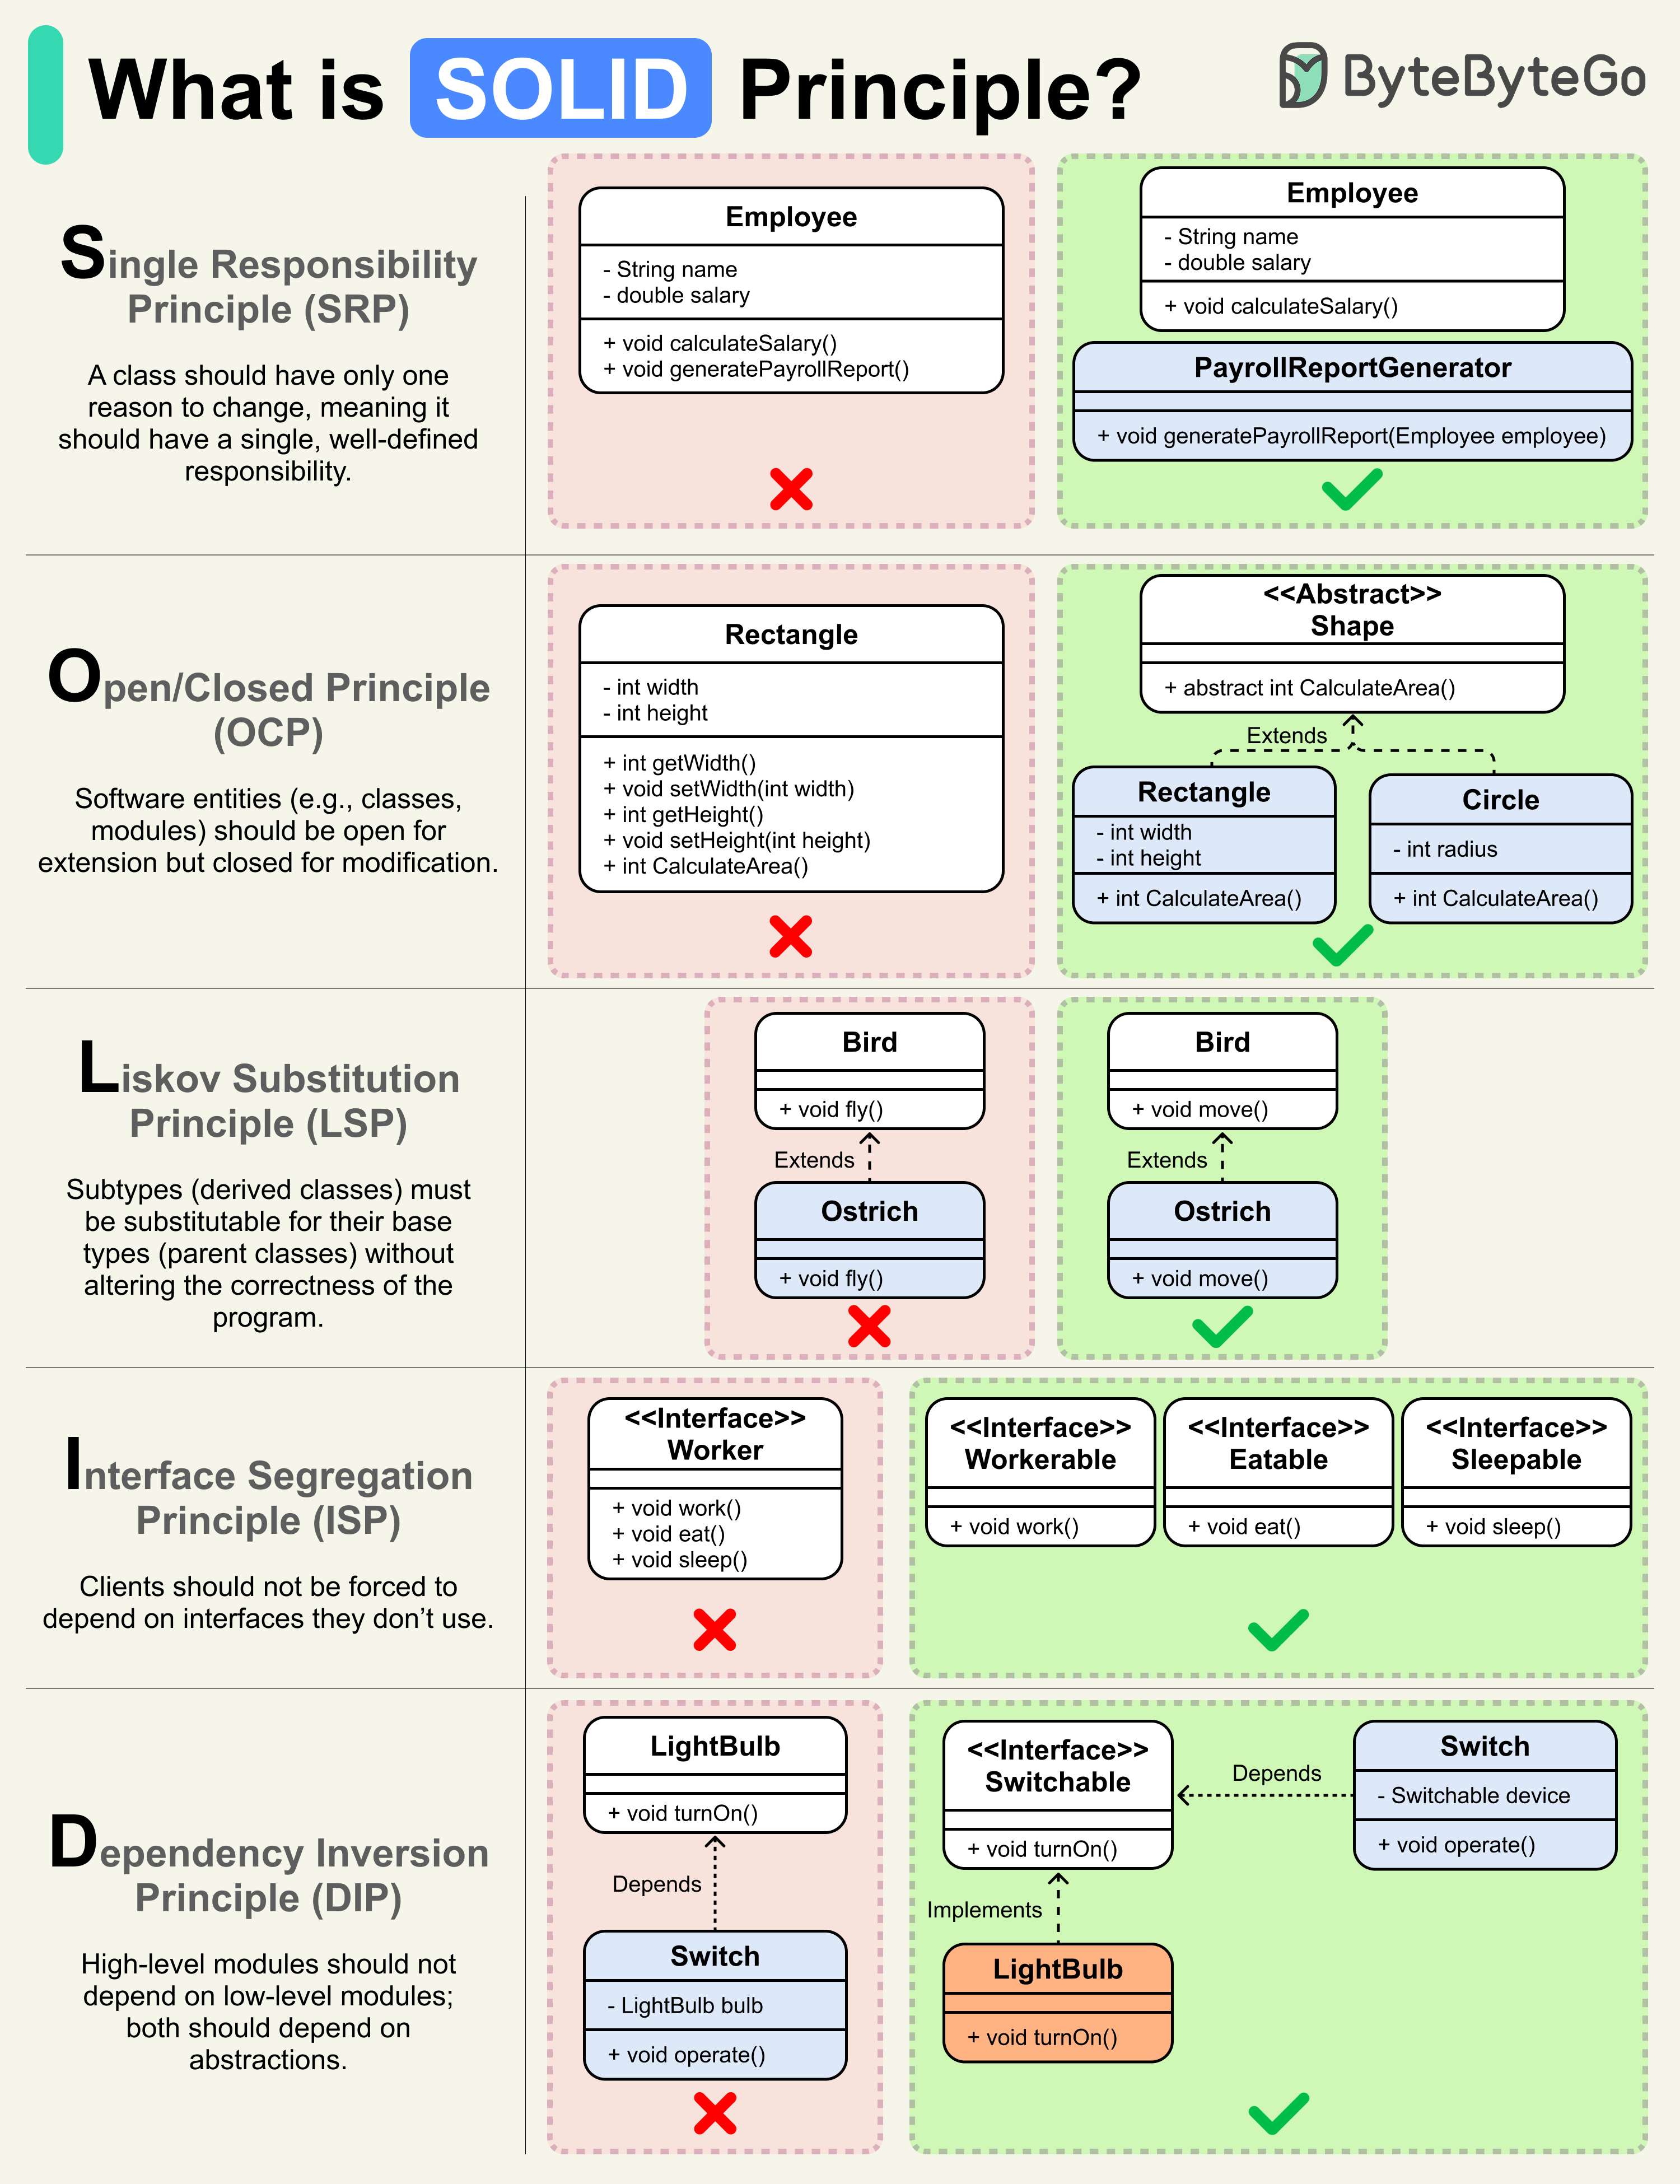
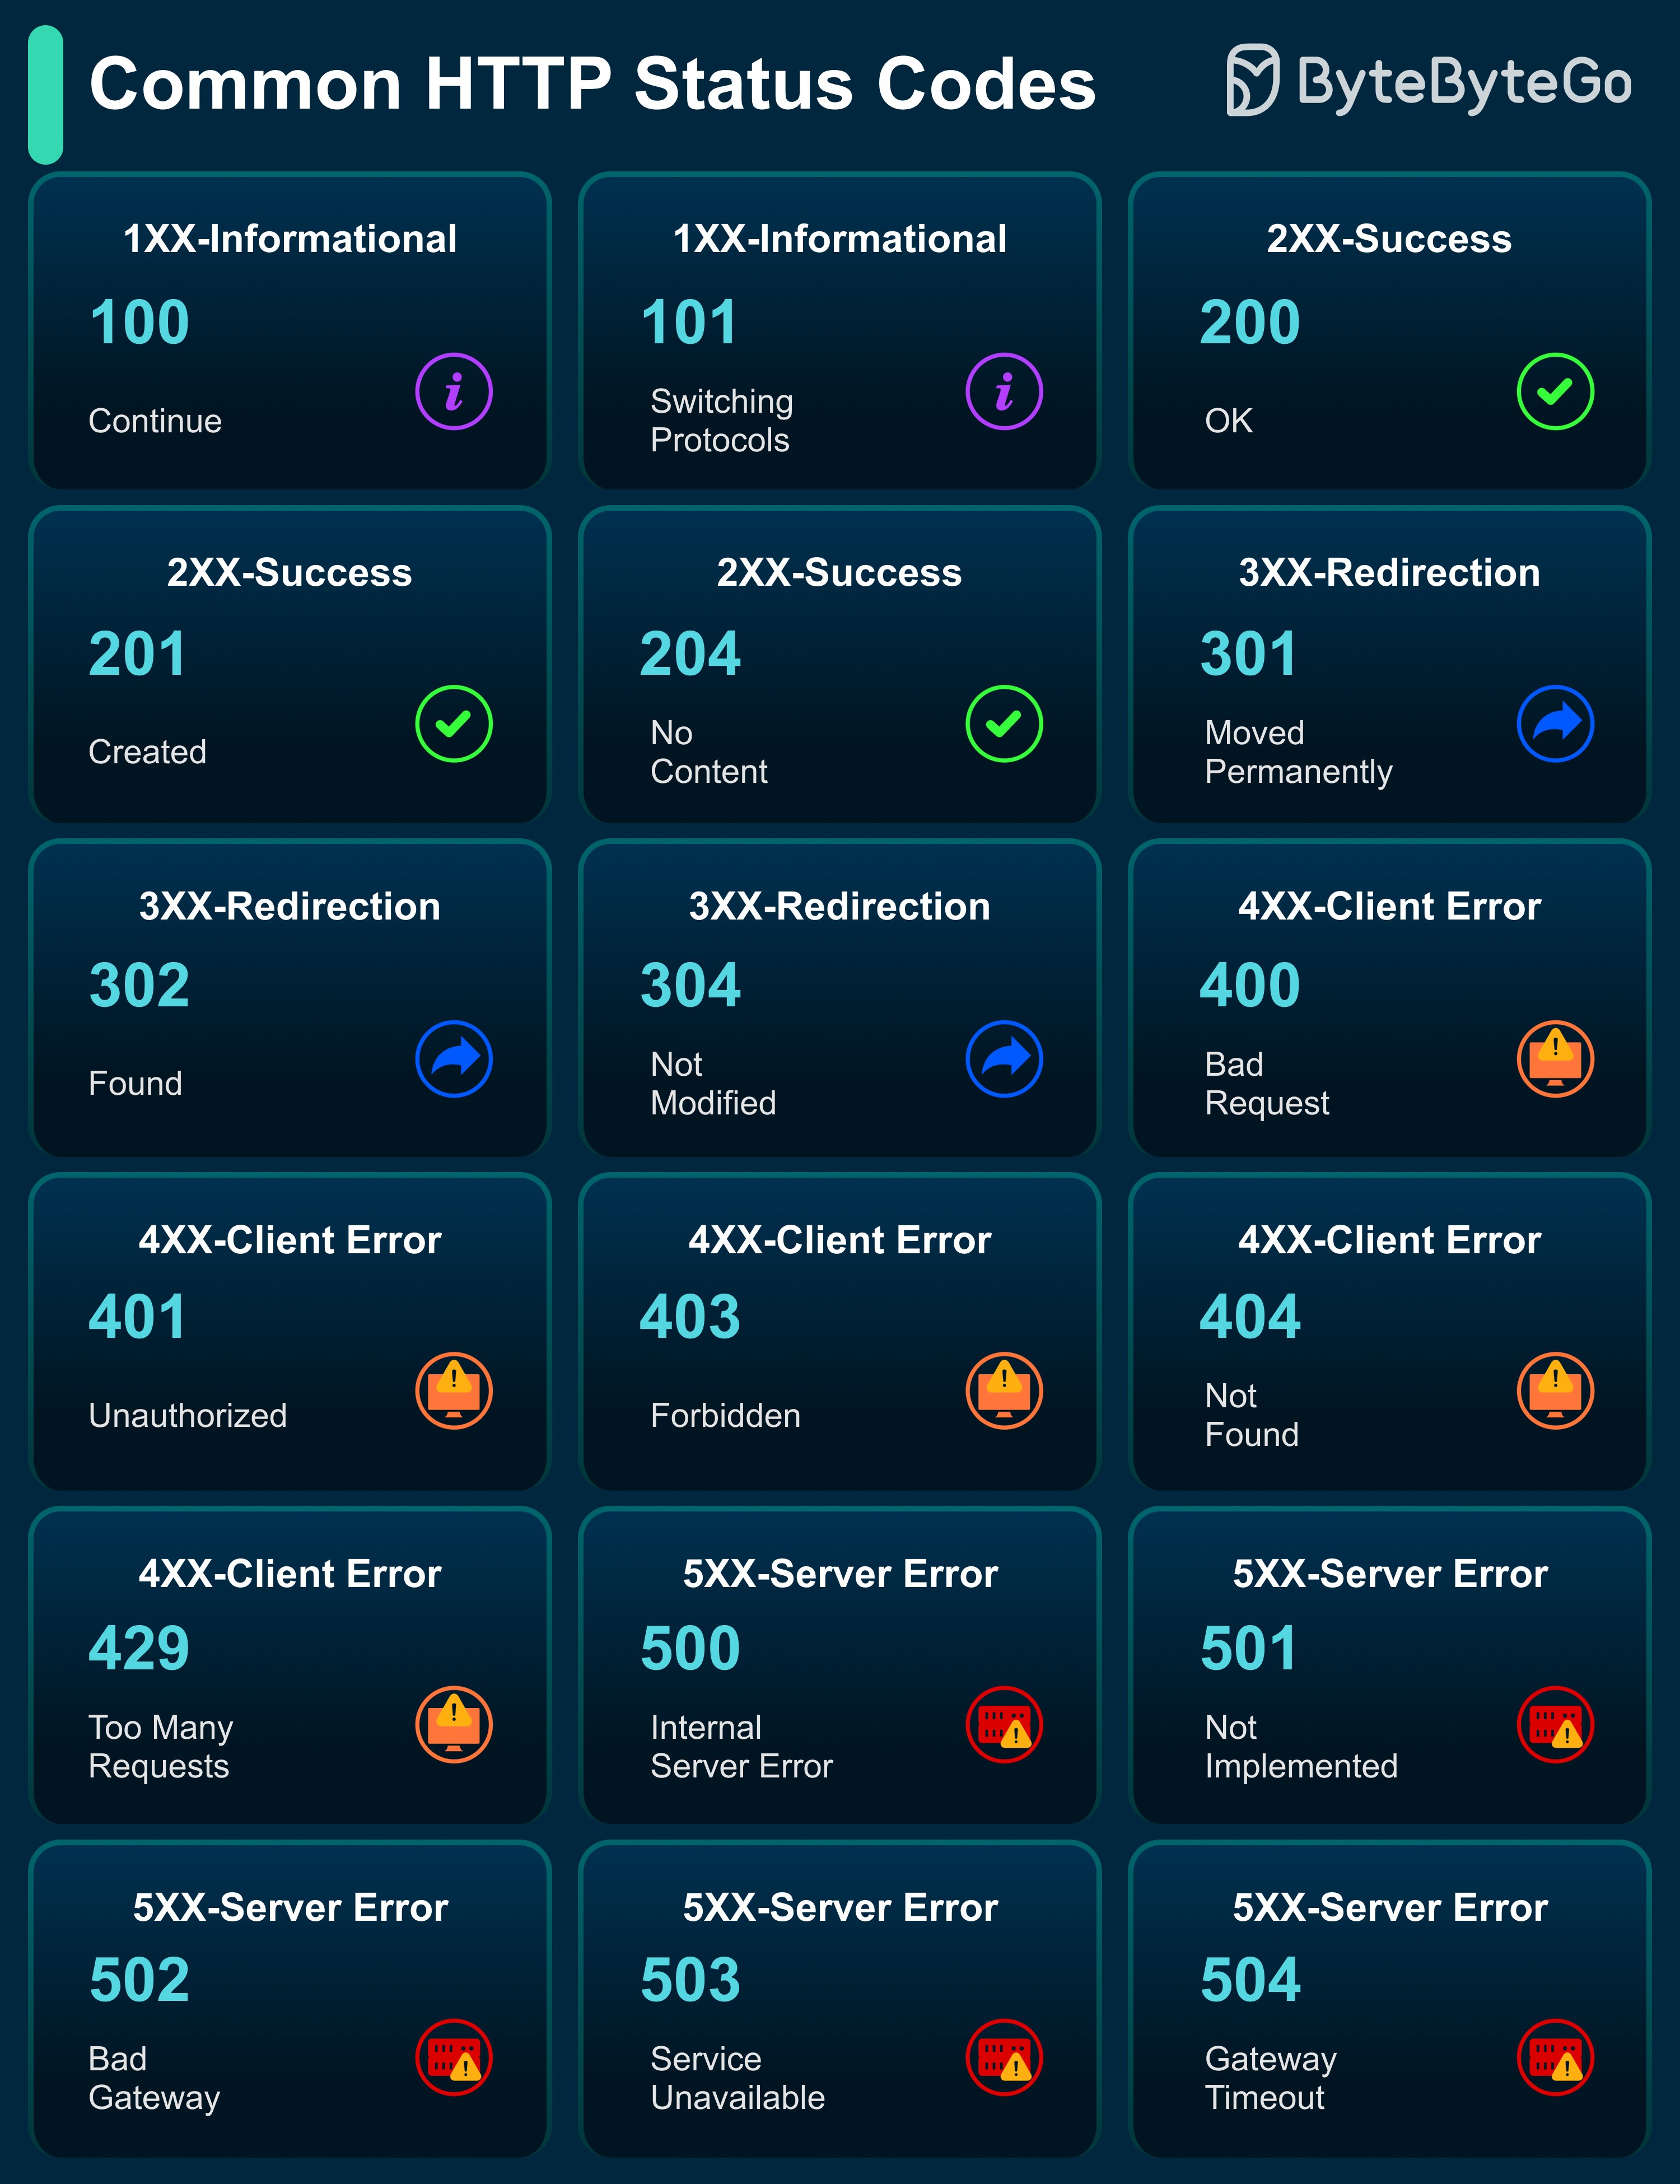
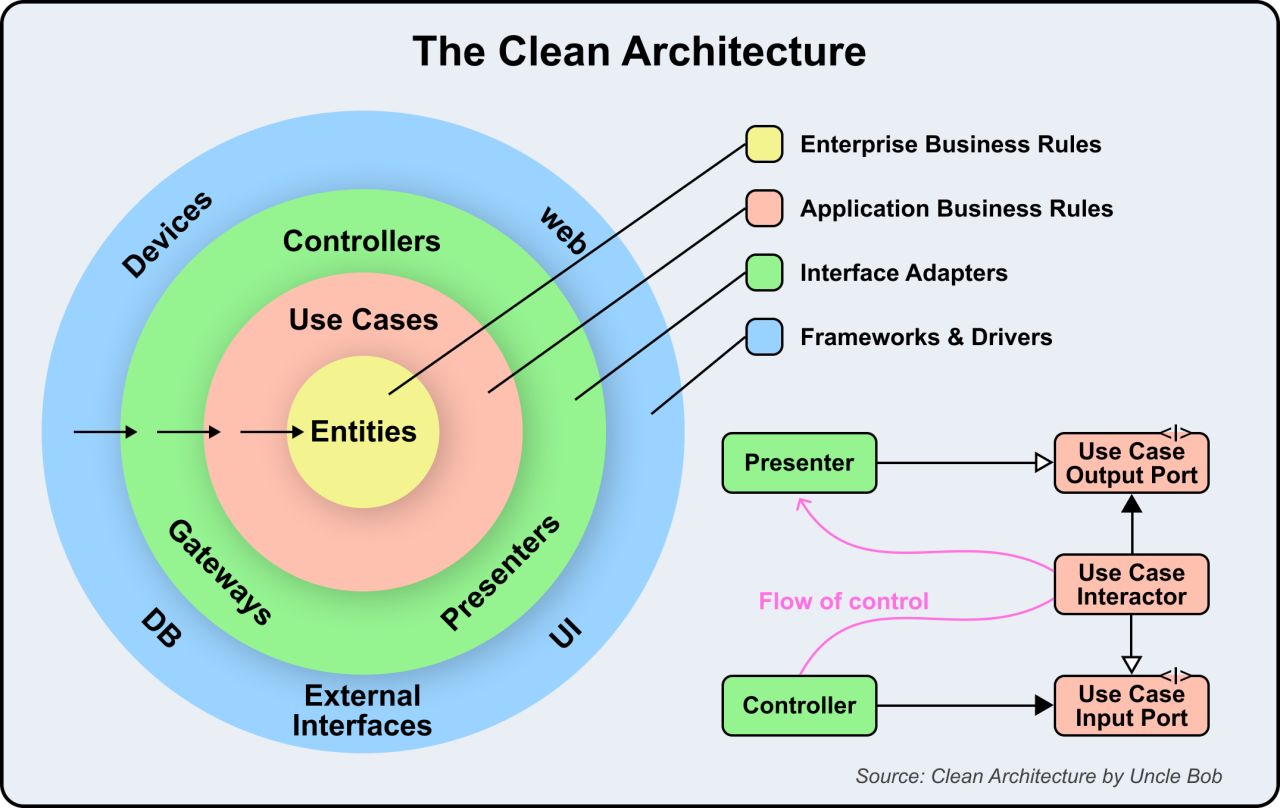
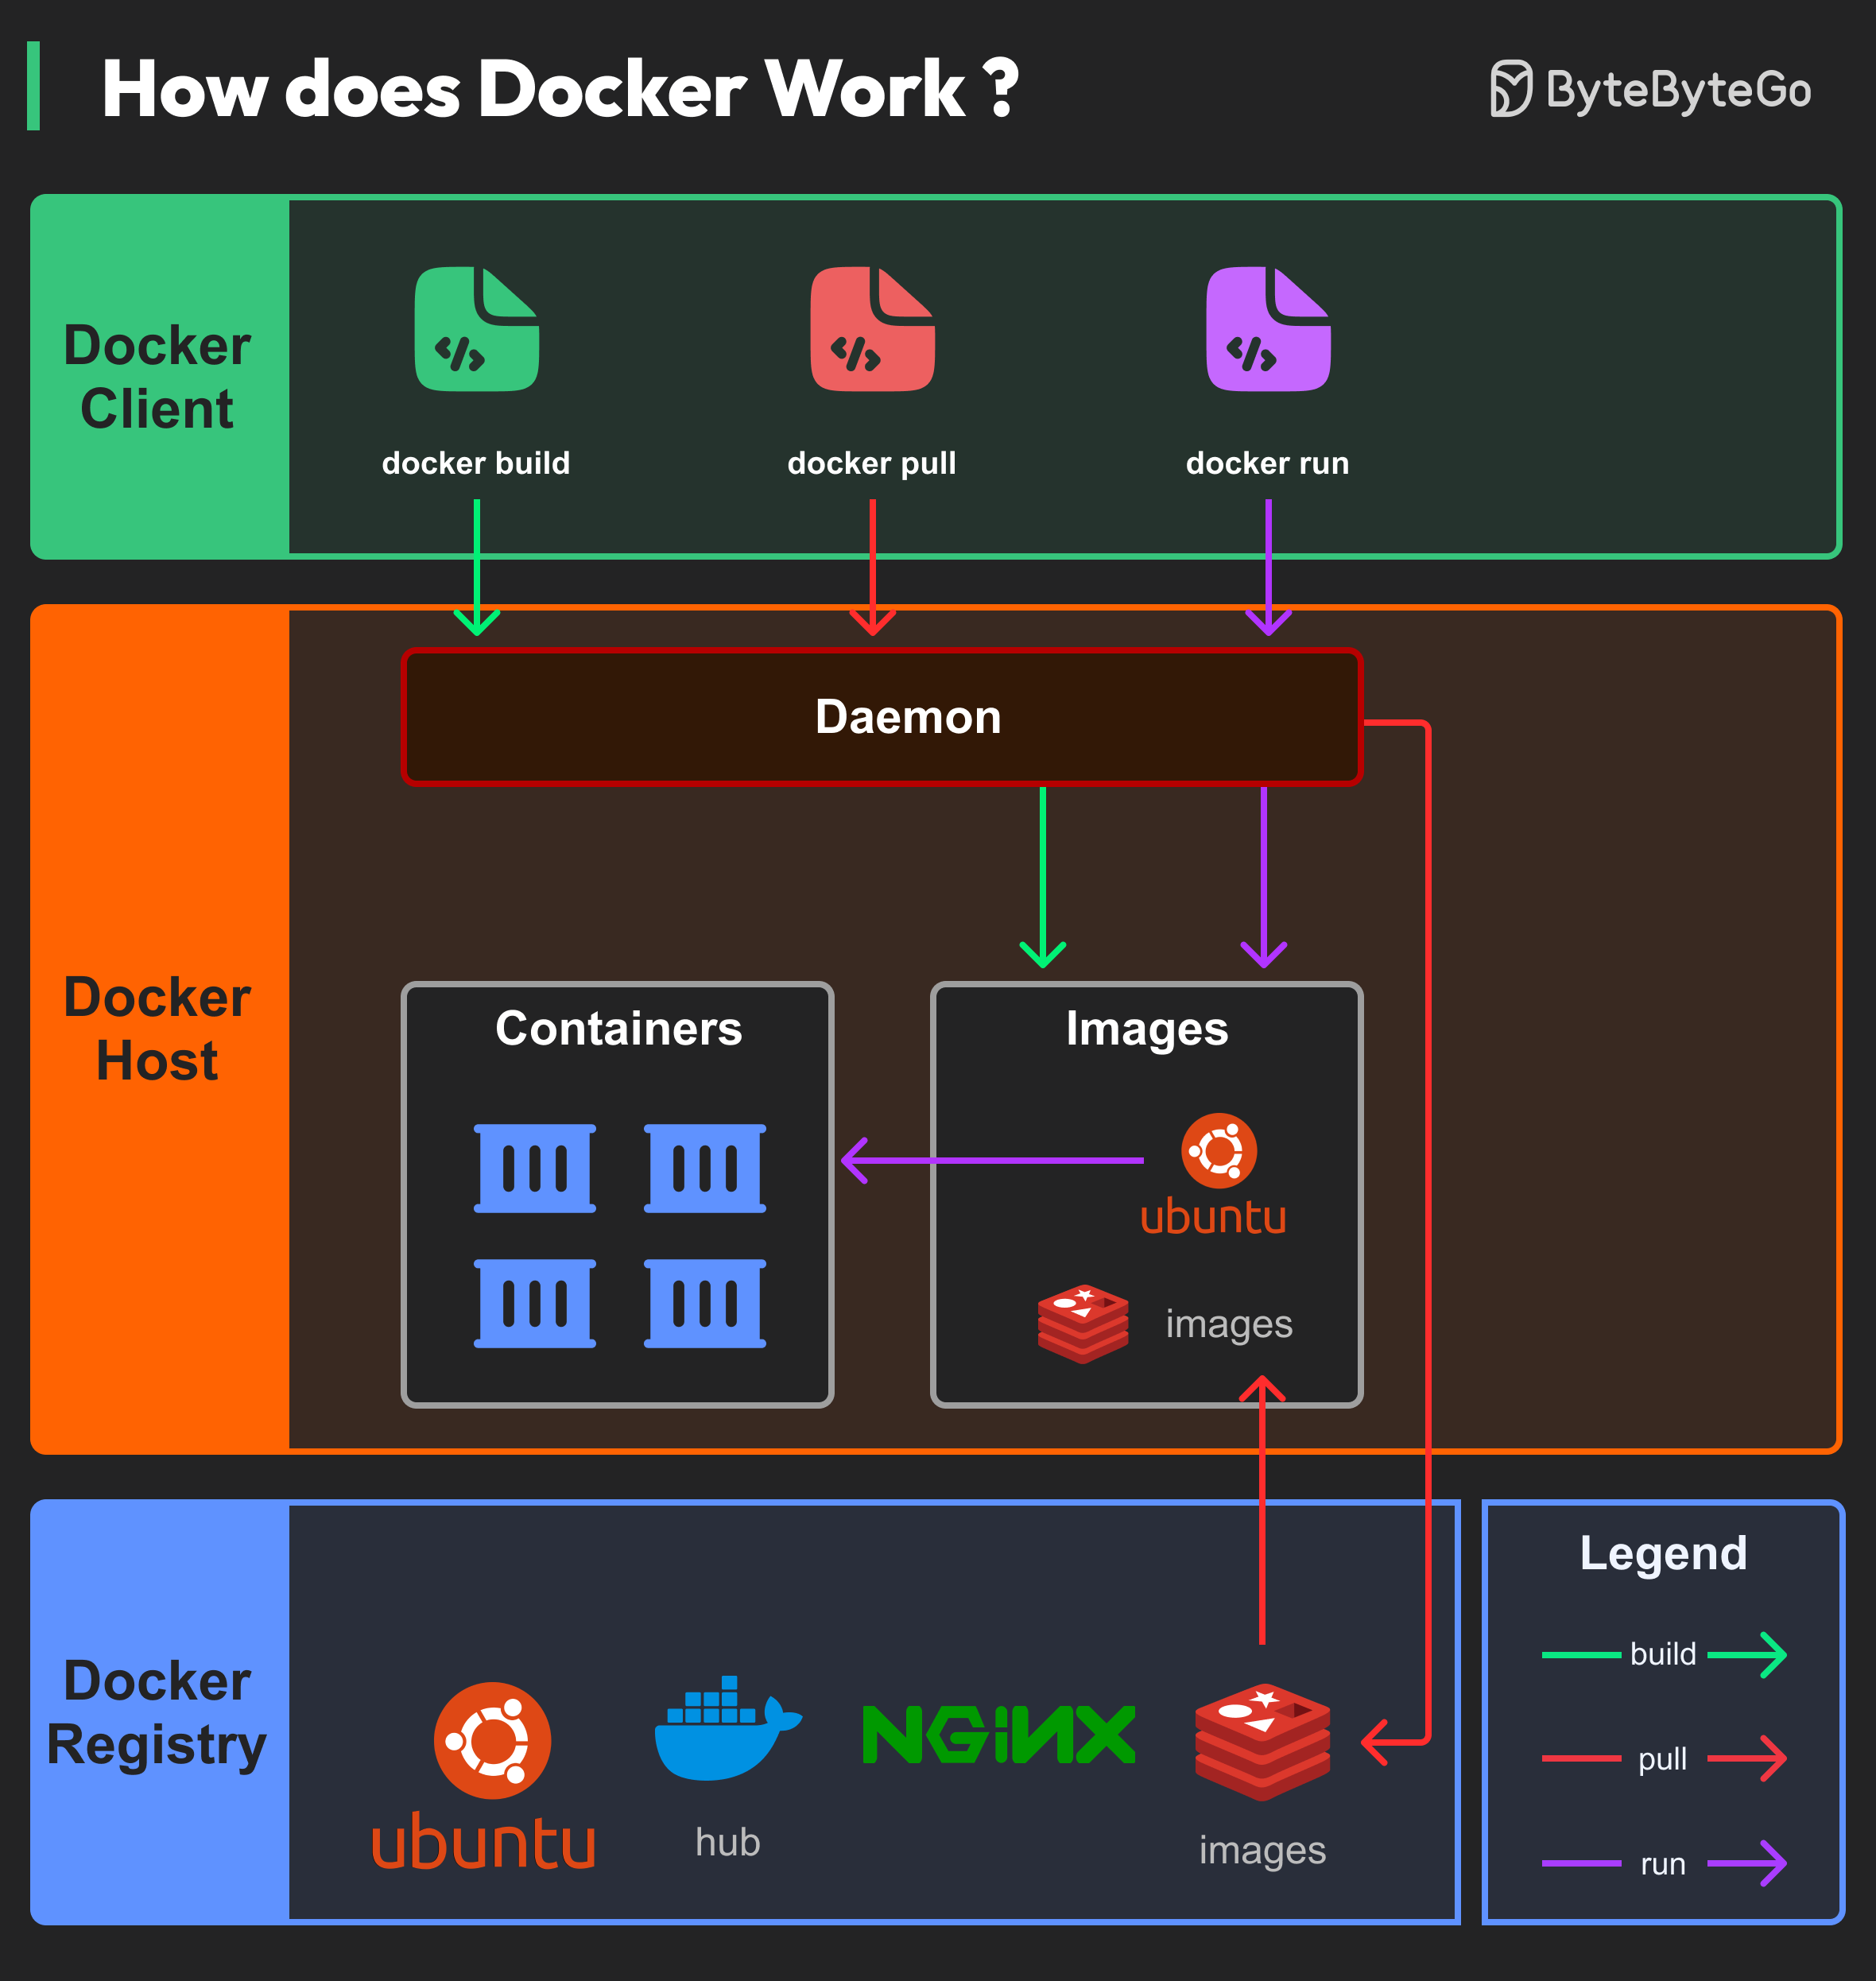
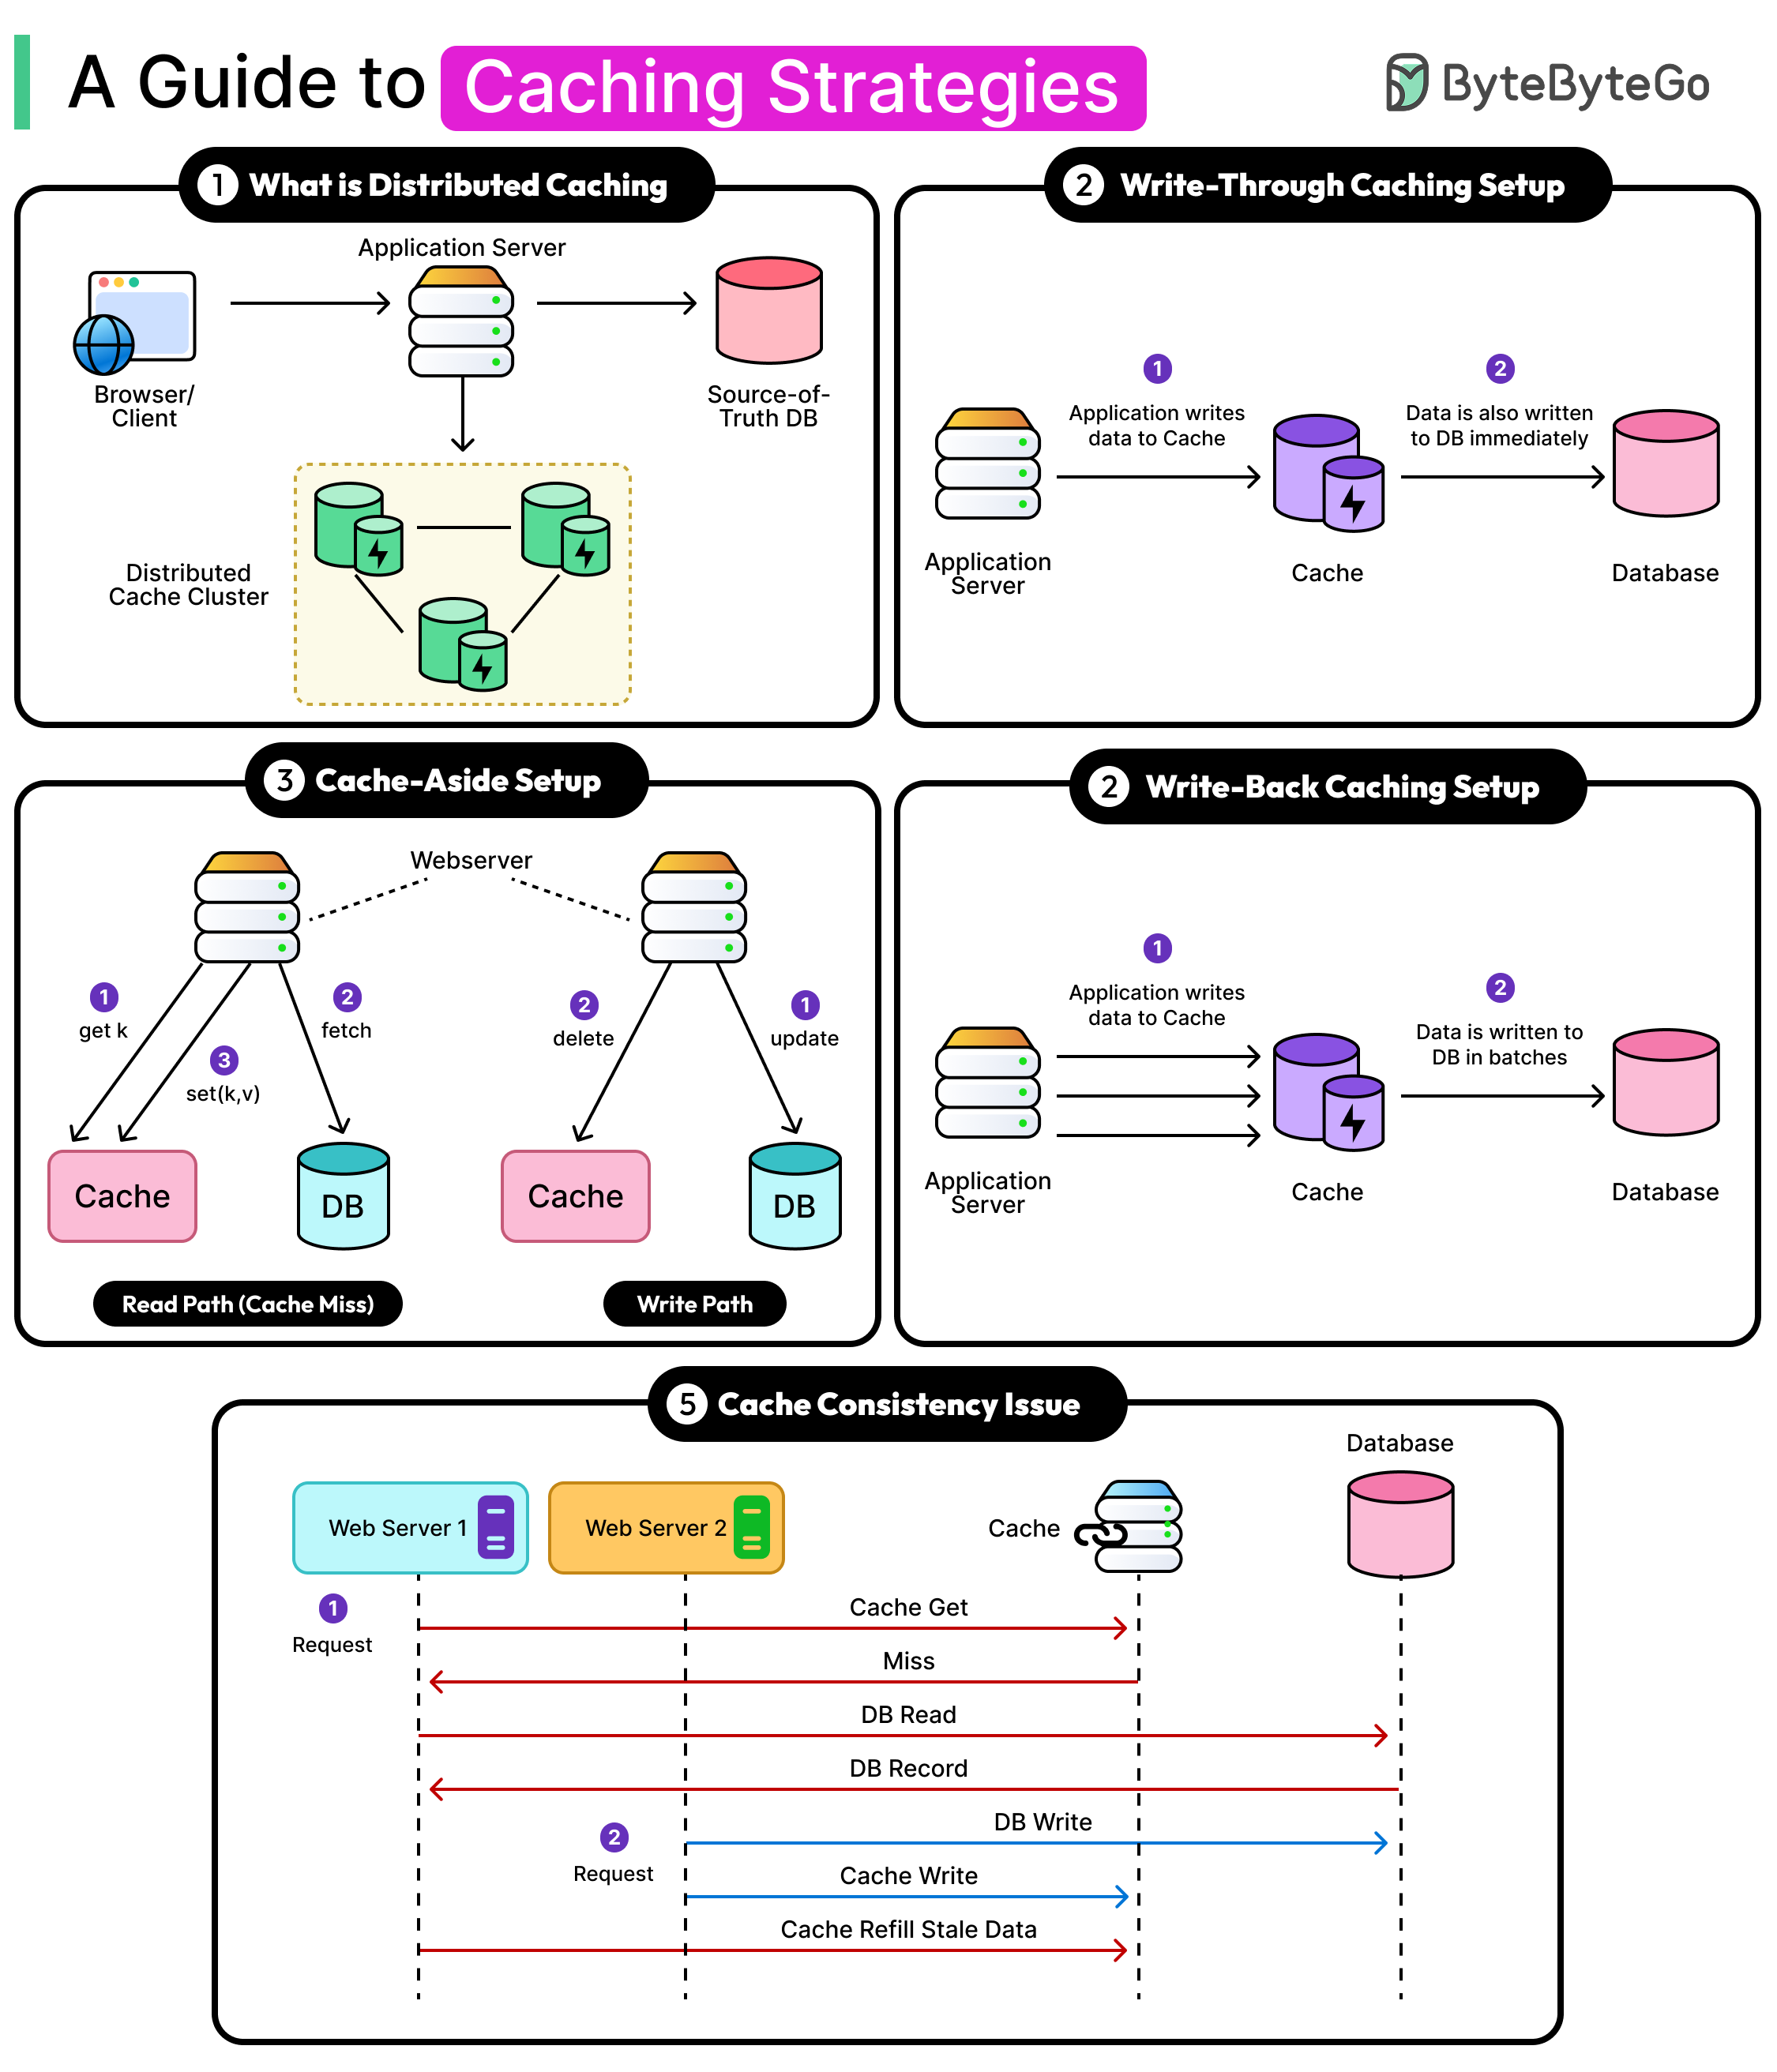
Bonus: Vài ảnh hay ho đến từ ByteByteGo
Bài viết đã được viết lại bởi Claude Code với Opus 5.5 vào ngày 27/09/2026.