Một vấn đề mình nhận ra nhưng lười sửa đổi đó là mình đọc nhiều blog, nghịch nhiều tool, nhưng không có cái nào mình thật sự nghiêm túc, đủ để viết thành một blog chất lượng cả. Nếu có gì tâm đắc thì mình cũng quá lười để viết lại.
Vì vậy mình chuyển sang thử một hình thức khác, đó là tổng hợp lại những bài blog hay mà mình đã tìm thấy, đọc được trong tuần vừa qua và tổng hợp lại thành một bản newsletter hàng tuần. Mong được mọi người ủng hộ.
Không lòng vòng nữa, sau đây là Newsletter #1 của mình.
Seconds Since the Epoch
Nhiều người vẫn tin rằng thời gian POSIX (hay Unix time) là số giây đã trôi qua kể từ mốc 00:00:00 ngày 01/01/1970. Tác giả chỉ ra rằng điều này không hoàn toàn đúng: tiêu chuẩn IEEE 1003.1 định nghĩa thời gian POSIX dựa trên giờ UTC và giả định mỗi ngày dài đúng 86.400 giây. Trên thực tế, độ dài một ngày thay đổi theo thời gian, nên các nhà thiên văn định kỳ chèn thêm giây nhuận vào UTC để giờ UTC không lệch quá xa so với ngày mặt trời. Hệ quả là vào thời điểm viết bài (cuối năm 2024), giá trị thời gian POSIX thấp hơn 27 giây so với số giây thực sự đã trôi qua, và cứ vài năm đồng hồ POSIX lại nhảy lùi một lần, từng gây ra nhiều sự cố nghiêm trọng trên Internet.
Bài viết trích dẫn phần phụ lục của tiêu chuẩn, cho thấy nhóm soạn thảo biết rõ sự sai lệch này nhưng chủ động bỏ qua để việc tính toán đơn giản hơn. Về giải pháp, tác giả khuyên dùng CLOCK_MONOTONIC hoặc CLOCK_BOOTTIME khi chỉ cần đo khoảng thời gian trên một máy; dùng TAI hoặc GPS nếu không phải trao đổi mốc thời gian với hệ thống khác; và dàn trải giây nhuận ra một khoảng thời gian dài hơn nếu vẫn cần tương thích với các hệ thống dùng thời gian POSIX. Cuối bài có nhắc tới nỗ lực loại bỏ hẳn giây nhuận, dự kiến hoàn thành vào năm 2035.
B-Trees: More Than I Thought I’d Want to Know
Dựa trên cuốn Database Internals của Alex Petrov, tác giả giải thích lại cây B (B-Tree) theo góc nhìn thực tế thay vì những công thức khô khan trên giảng đường. Câu hỏi xuất phát rất rõ ràng: khi tập khóa – giá trị không còn vừa trong bộ nhớ, làm sao thiết kế một cấu trúc thân thiện với ổ đĩa? Đọc ghi đĩa chậm hơn nhiều so với RAM và luôn thao tác theo cả trang, nên một cây nhị phân tìm kiếm (BST) lưu trên đĩa sẽ tốn gần như một lần truy cập đĩa cho mỗi lần so sánh khóa. Cây B khắc phục điều này bằng cách gom hàng trăm khóa vào cùng một nút (độ phân nhánh cao), nhờ đó mỗi lần đọc đĩa cho phép so sánh được nhiều khóa hơn.
Tác giả tiếp tục đi vào các chi tiết cài đặt: trang có khe (slotted page) gồm phần đầu trang, các ô dữ liệu và mảng con trỏ, giúp sắp xếp lại khóa mà không phải di chuyển dữ liệu; rút gọn khóa phân tách ở các nút trong để chứa được nhiều khóa hơn; trang tràn giữ phần tiền tố của khóa dài ở trang chính để phần lớn truy vấn không cần đọc thêm; và con trỏ anh em giúp quét theo khoảng mà không phải quay ngược lên nút cha. Bài kết thúc bằng một số biến thể như cây B lười, FD-Tree, Bw-Tree, cùng nhận định rằng các tối ưu cài đặt không làm thay đổi độ phức tạp Big-O nhưng lại ảnh hưởng lớn đến hiệu năng thực tế của cơ sở dữ liệu.
SQL NULLs are Weird!
Tác giả chia sẻ một hành vi dễ gây bất ngờ gặp phải khi làm việc với Convoy và LiteQueue: trong SQL, NULL = NULL không trả về đúng mà trả về NULL, vì NULL đại diện cho một giá trị chưa biết. Hệ quả là với ràng buộc UNIQUE, mỗi giá trị NULL được coi là khác nhau, nên một cột (hoặc một tổ hợp cột như UNIQUE(email, deleted_at)) vẫn có thể chứa nhiều dòng “trùng lặp” khi có NULL. Hành vi này được kiểm chứng trên SQLite, PostgreSQL và MySQL, và tài liệu của SQLite cũng thừa nhận sự thiếu nhất quán: NULL được coi là khác nhau với UNIQUE nhưng lại giống nhau với SELECT DISTINCT và UNION.
Để đảm bảo tính duy nhất, bài viết đưa ra hai cách. Cách thứ nhất là thêm một cột sinh tự động dùng COALESCE để thay NULL bằng một giá trị cố định; cách này làm bảng rộng hơn và gặp lỗi khi xóa cùng một bản ghi hai lần. Cách thứ hai, được tác giả khuyến nghị, là tạo chỉ mục duy nhất một phần trên cột email với điều kiện deleted_at IS NULL, vừa tốn ít dung lượng vừa ít lỗi hơn. Ngoài ra, các hệ quản trị cơ sở dữ liệu hiện đại còn hỗ trợ IS [NOT] DISTINCT FROM để so sánh các giá trị NULL một cách rõ ràng.
Understanding JVM Garbage Collector Performance
Bài viết trên blog của Mill giúp bạn hiểu bộ thu gom rác (GC) của JVM từ nền tảng lý thuyết đến số liệu đo đạc thực tế. Tác giả bắt đầu với một GC sao chép đơn giản: lần theo các tham chiếu từ gốc để tìm những đối tượng còn sống (live-set), sao chép chúng sang nửa heap còn trống rồi xóa sạch nửa cũ; đồng thời so sánh với cơ chế đếm tham chiếu, vốn không nén được heap và không thu hồi được các tham chiếu vòng. Từ mô hình này rút ra vài kết luận quan trọng: cấp phát bộ nhớ rất rẻ, thời gian dừng tỉ lệ với kích thước live-set chứ không phụ thuộc vào lượng rác, còn chi phí GC giảm dần khi heap càng lớn so với live-set.
Các phép đo với G1 (GC mặc định) và ZGC xác nhận những nhận định trên. Thêm bộ nhớ không làm giảm thời gian dừng mà chỉ tăng thông lượng; đối tượng sống ngắn được thu gom nhanh hơn nhiều nhờ tối ưu theo thế hệ; còn ZGC có thể đưa thời gian dừng xuống vài mili giây nếu bạn chấp nhận cấp thêm khoảng gấp đôi bộ nhớ. Phần tổng kết đưa ra các lời khuyên thực tế: giảm live-set bằng cách chuyển dữ liệu lớn ra ngoài tiến trình (SQLite, Redis, Memcached), cẩn trọng với bộ nhớ đệm LRU đặt ngay trong tiến trình, và lưu ý rằng gộp nhiều tiến trình nhỏ thành một tiến trình lớn có thể khiến thời gian dừng tệ hơn.
A Deep Dive into JVM Start-Up
Trước khi dòng lệnh System.out.println("Hello World") quen thuộc được thực thi, JVM đã phải làm rất nhiều việc phía sau. Bài trình bày này trên kênh YouTube chính thức của Java đưa bạn đi qua toàn bộ quá trình khởi động của JVM: phân tích các tham số, kiểm tra tài nguyên hệ thống, thiết lập môi trường, rồi đến các bước tải, liên kết và khởi tạo lớp – tức là những gì JVM cần làm để “tạo ra vũ trụ” cho ứng dụng của bạn.
Phần cuối video giới thiệu những thay đổi sắp tới với Project Leyden, hứa hẹn cải thiện đáng kể thời gian khởi động và hiệu năng của JVM. Đây là tài liệu tham khảo hữu ích cho các lập trình viên Java muốn hiểu sâu hơn về nền tảng cốt lõi đang sử dụng hằng ngày.
Parallel processing with Virtual Threads - A comparative analysis
Tiếp nối bài viết trước so sánh xử lý song song giữa Spring Core Reactor và JDK 21, lần này tác giả đánh giá hai cách tiếp cận đó khi chạy trên luồng ảo (virtual thread). Bài viết nhắc lại hạn chế của luồng hệ điều hành: tốn tài nguyên, số luồng đồng thời có giới hạn, thao tác chặn làm giảm khả năng mở rộng và chi phí chuyển ngữ cảnh cao. Luồng ảo thuộc Project Loom do JVM quản lý nên rất rẻ để tạo và chặn, có thể tạo tới hàng triệu luồng, và đặc biệt phù hợp với các tác vụ nặng về I/O. Tác giả trình bày mã nguồn cho cả hai phiên bản: một dùng CompletableFuture với bộ thực thi luồng ảo của JDK, một dùng Flux và Mono của Reactor chạy trên cùng bộ thực thi đó.
Kết quả đo với danh sách 100.000, 250.000 và 500.000 đối tượng cho thấy phiên bản JDK nhanh hơn Reactor rất nhiều, và khoảng cách càng lớn khi số đối tượng tăng. Đổi lại, phiên bản JDK chiếm nhiều bộ nhớ hơn hẳn ở vùng Old Gen, có thời gian dừng GC và thời gian CPU dành cho GC cao hơn, nhưng theo tác giả những điều này không ảnh hưởng đáng kể đến độ trễ của ứng dụng. Kết luận của bài: với luồng ảo, JDK là lựa chọn hiển nhiên; còn với luồng nền tảng truyền thống, Spring Core Reactor lại nhanh hơn đôi chút.
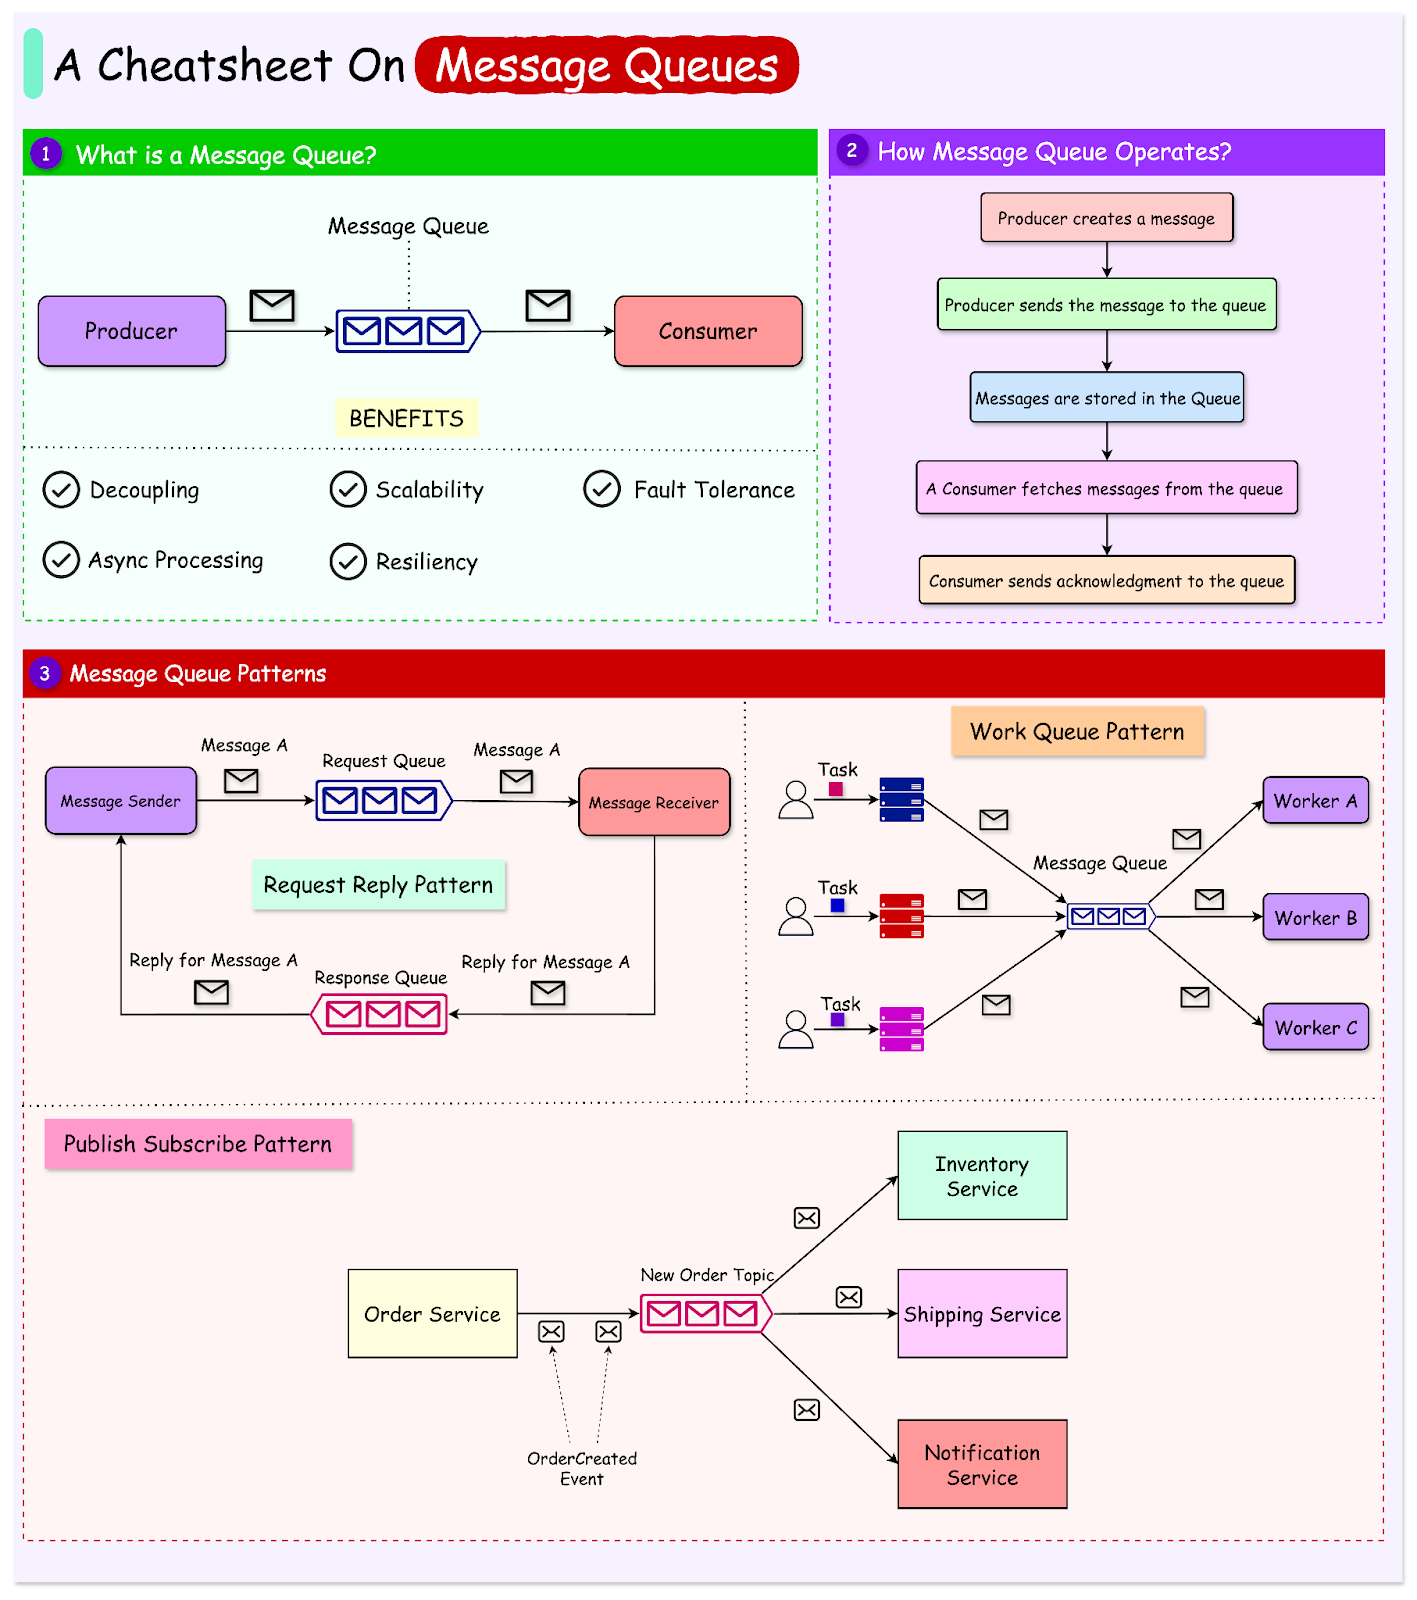
Bonus: Vài ảnh hay ho đến từ ByteByteGo

Bài viết đã được viết lại bởi Claude Code với Opus 5.5 vào ngày 27/09/2026.